Nền tảng NVIDIA GB300: Bản thiết kế chuẩn mực cho siêu mô hình nghìn tỷ tham số
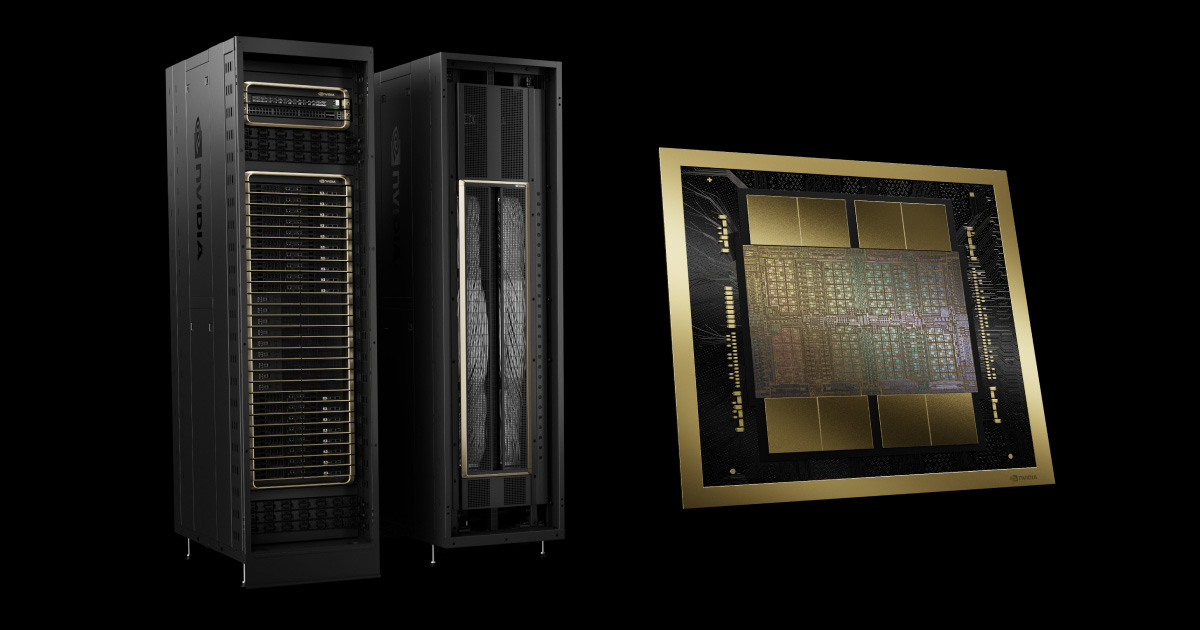
Kỷ nguyên của Trí tuệ nhân tạo đang bước sang một chương mới với sự thống trị của các Tác nhân AI (Agentic AI) độc lập và các siêu mô hình ngôn ngữ lớn (LLM) vượt mốc hàng nghìn tỷ tham số. Ở quy mô khổng lồ này, bài toán đặt ra cho hạ tầng trung tâm dữ liệu đã thay đổi bản chất. Cuộc đua không còn nằm ở việc đơn thuần bổ sung sức mạnh tính toán thô (Compute) hay tìm cách “kết dính” CPU và GPU như giai đoạn trước, mà là làm sao tối ưu hóa triệt để luồng dữ liệu khổng lồ trong các mạng lưới suy luận thời gian thực.
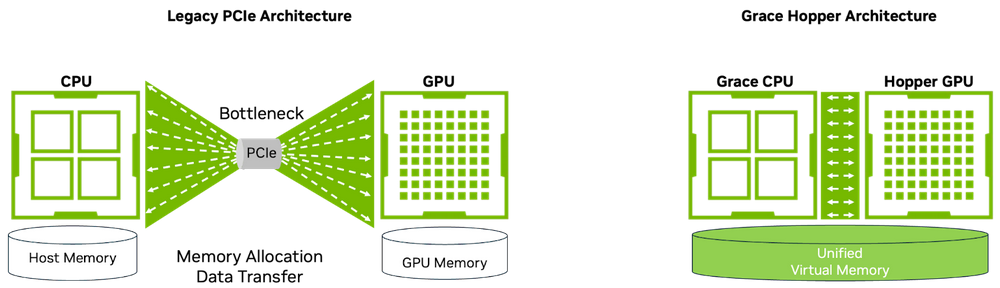
Sự phân mảnh của kiến trúc máy chủ x86 truyền thống (với CPU và GPU giao tiếp rời rạc qua PCIe) vốn đã chạm ngưỡng giới hạn từ lâu. Dù ngành công nghiệp điện toán đã bắt đầu chuyển dịch sang các kiến trúc bộ nhớ đồng nhất (unified memory) để giải quyết “bức tường bộ nhớ”, nhưng tốc độ phình to của AI tạo sinh lại đòi hỏi một bước nhảy vọt xa hơn thế. Việc chia sẻ bộ nhớ là chưa đủ; hạ tầng hiện đại cần một kiến trúc có khả năng đẩy mật độ tính toán, băng thông liên kết và hiệu suất năng lượng lên một tầm vóc hoàn toàn khác biệt để xử lý các mô hình Hỗn hợp chuyên gia (MoE) phức tạp.
Đó chính là bối cảnh khai sinh ra nền tảng NVIDIA GB300 Grace Blackwell Ultra Superchip. Tiếp nối di sản kiến trúc cộng sinh từ các thế hệ tiền nhiệm, GB300 không chỉ là một bản nâng cấp, mà là một sự tiến hóa toàn diện về thiết kế silicon. NVIDIA đã đưa triết lý “Superchip” vươn tới giới hạn tối đa của vật lý bán dẫn, tinh chỉnh lại cách thức các lõi Tensor tương tác với dữ liệu và mở rộng quy mô bộ nhớ đồng nhất lên mức chưa từng có.
Thay vì chỉ tập trung giải quyết bài toán nút thắt giao tiếp nội bộ, GB300 chuyển trọng tâm sang việc kiến tạo một bệ phóng hoàn hảo cho khả năng mở rộng quy mô (Scale-out) cấp độ Data Center. Nó biến những khái niệm công nghệ tiên tiến nhất trở thành một chuẩn mực hạ tầng mới, mang đến lời giải tối ưu nhất cho bài toán hiệu năng và chi phí khi triển khai các siêu tác nhân AI ở quy mô thương mại.
Triết lý “Superchip” và Những Trụ cột Công nghệ Định hình Nền tảng GB300
Sự ra đời của nền tảng GB300 không đơn thuần là một bước tiến vi mạch, mà là một kỳ quan vật lý bán dẫn. GPU kiến trúc Blackwell Ultra được chế tạo trên tiến trình TSMC 4NP tùy chỉnh, đóng gói tới 208 tỷ bóng bán dẫn. Nó bao gồm hai khuôn vi mạch (die) kích thước tối đa liên kết với nhau bằng một siêu xa lộ nội bộ có băng thông chạm ngưỡng 10 TB/s, hoạt động liền mạch như một GPU duy nhất.
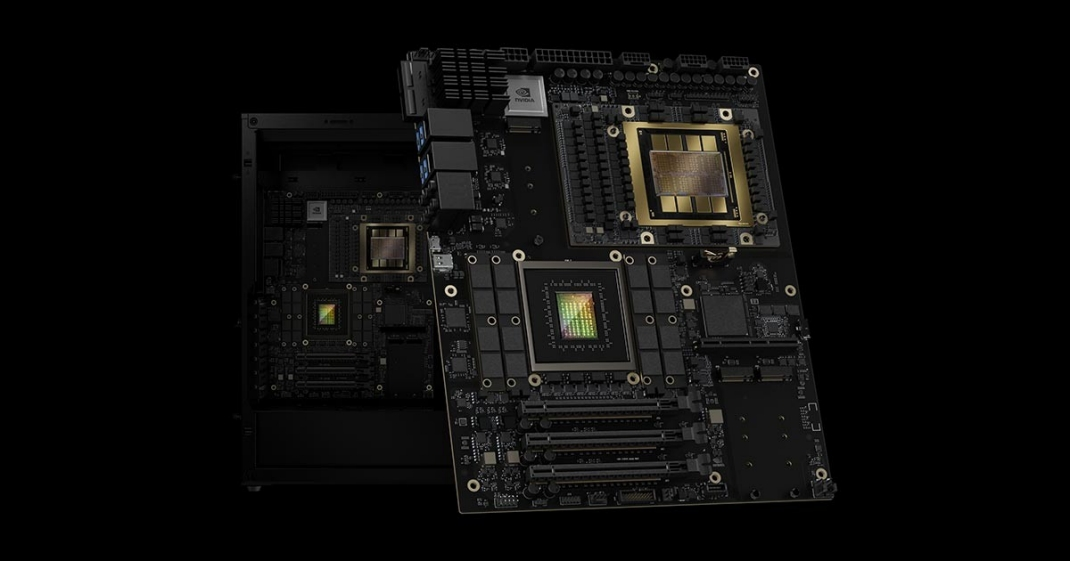
Sức mạnh định hình lại kỷ nguyên AI của kiến trúc Superchip này được xây dựng trên các trụ cột công nghệ cốt lõi:
-
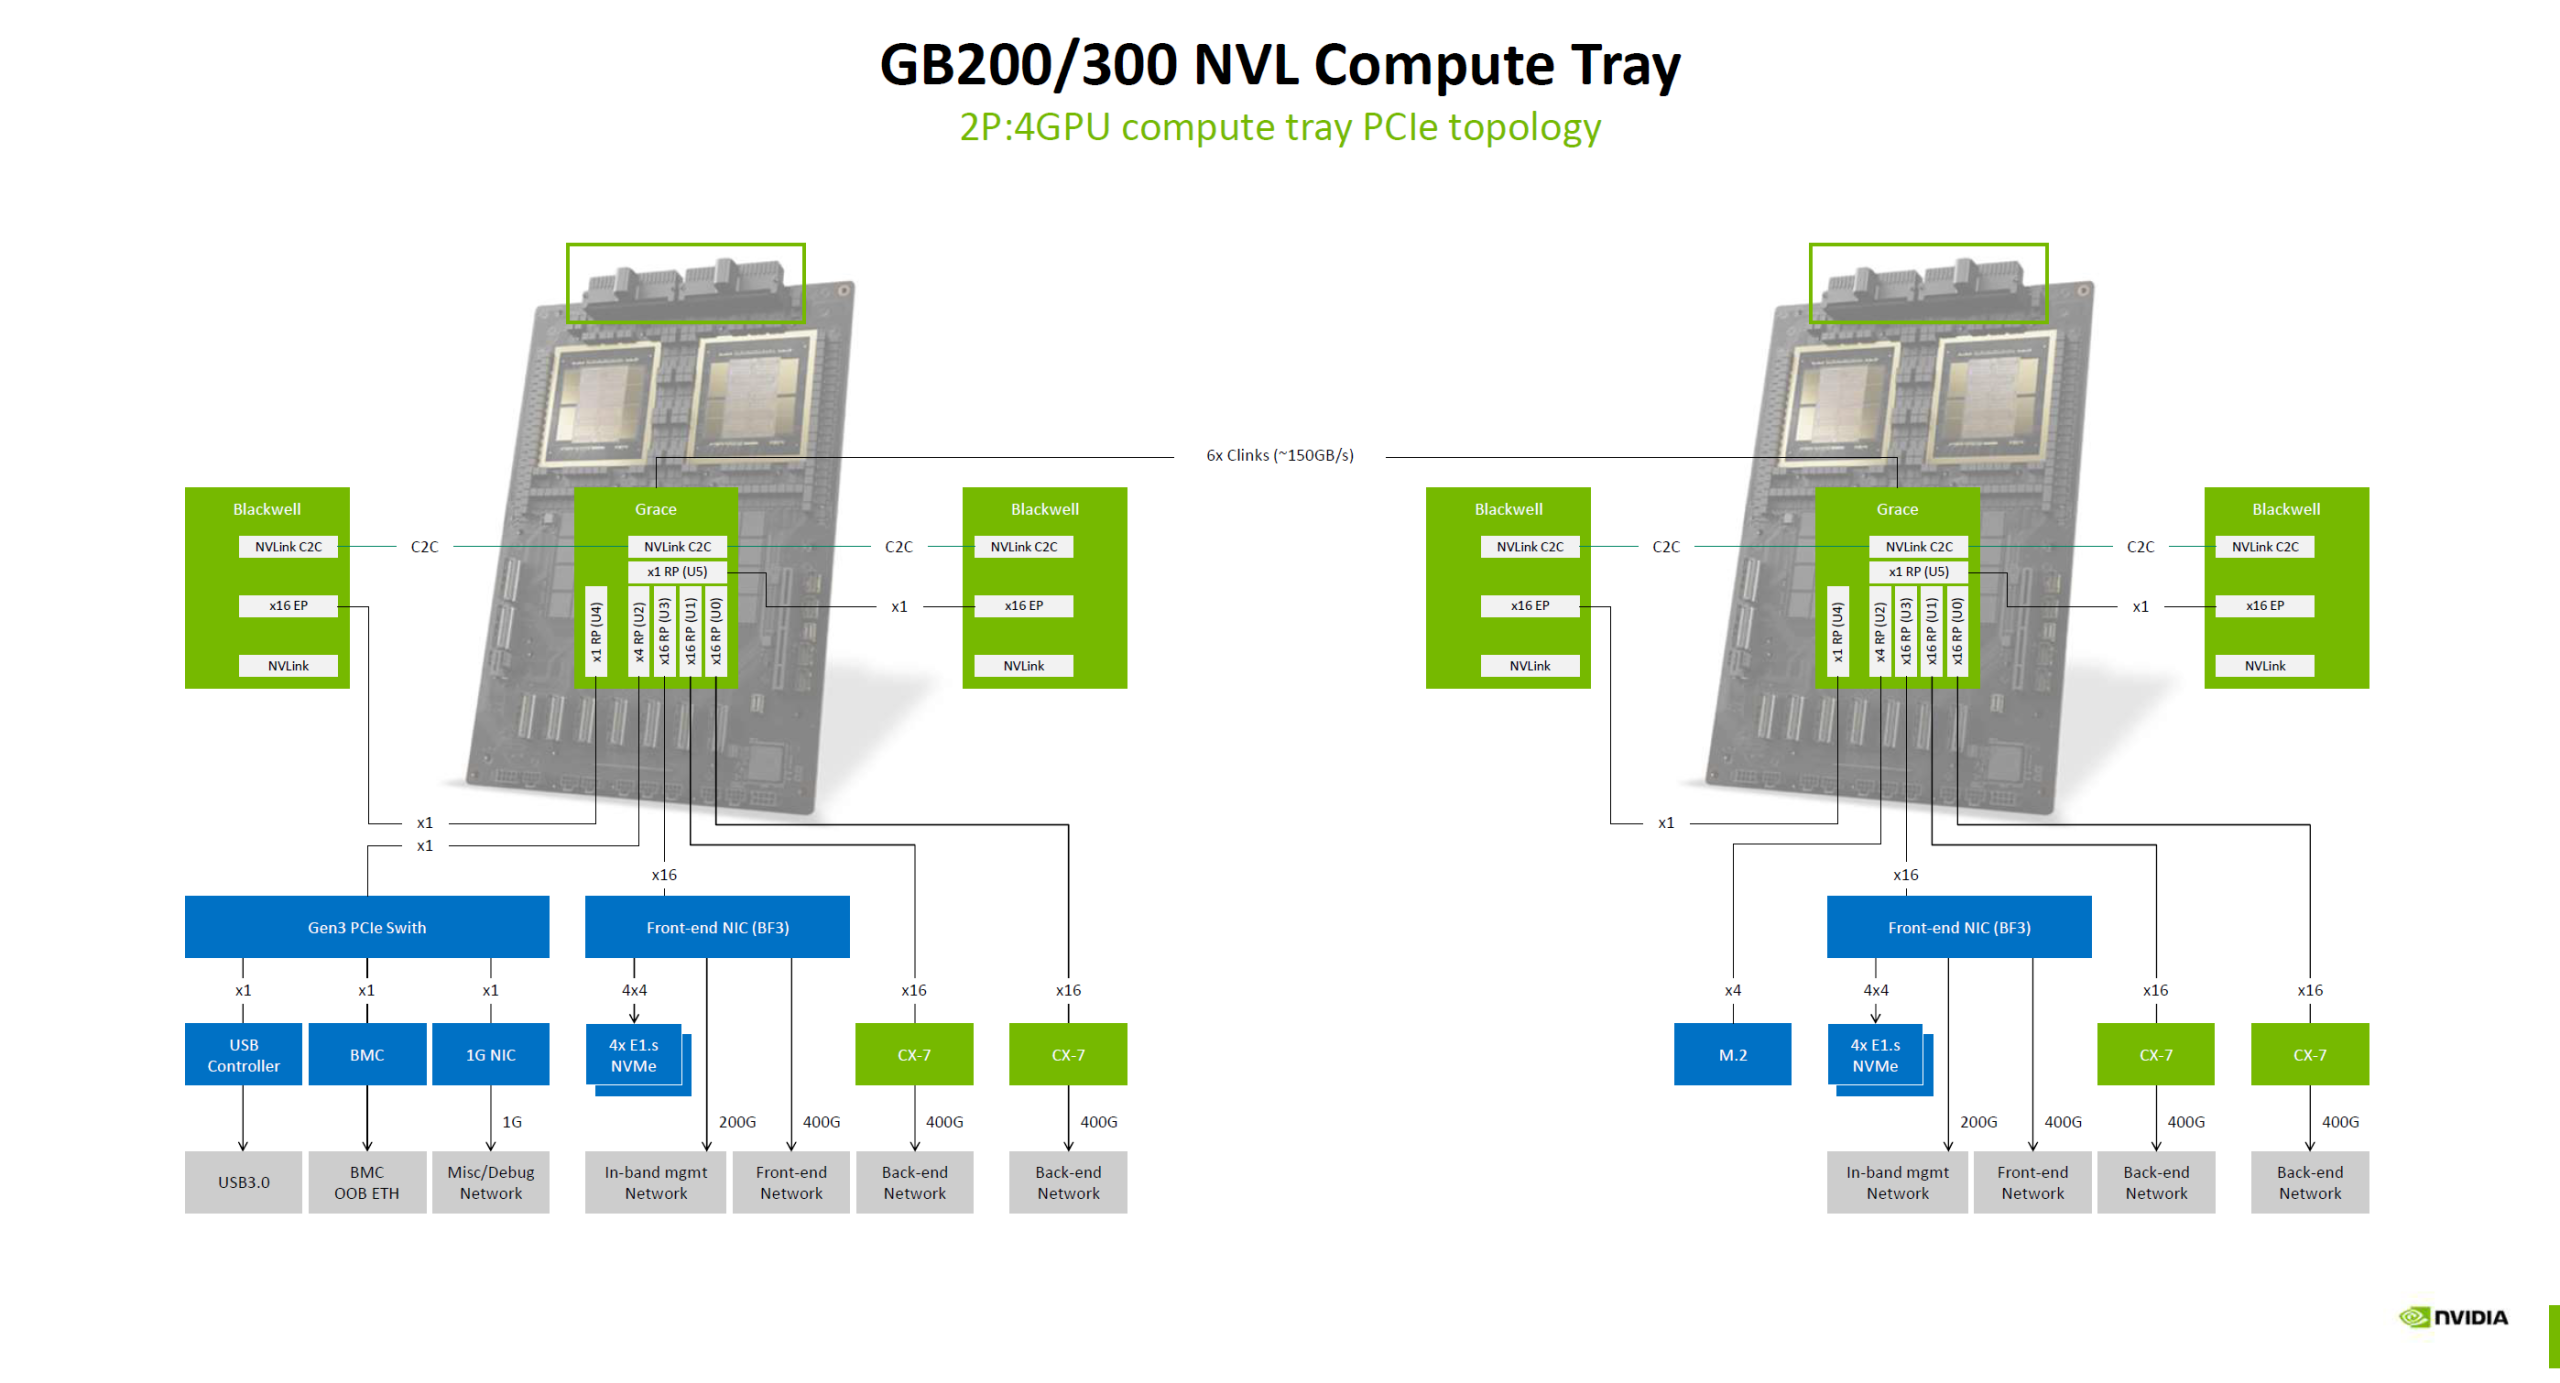
Băng thông dữ liệu NVLink-C2C siêu tốc và Động cơ Giải nén (Decompression Engine): Để phá vỡ nút thắt PCIe, NVIDIA đã từ bỏ hoàn toàn giao tiếp qua khe cắm rời. CPU Grace và GPU Blackwell liên kết trực tiếp tạo ra luồng băng thông cực đại 900 GB/s — triệt tiêu gần như hoàn toàn độ trễ truyền tải. Tận dụng băng thông siêu tốc này, NVIDIA tích hợp thêm Decompression Engine, cho phép CPU Grace nạp dữ liệu khổng lồ trực tiếp, tăng tốc toàn diện pipeline phân tích cơ sở dữ liệu (như Apache Spark) với các định dạng nén LZ4, Snappy, Deflate.
-
Không gian Bộ nhớ Đồng nhất (Coherent Memory): Đây chính là “vũ khí” cốt lõi đập tan bức tường bộ nhớ. GB300 kết hợp 252 GB HBM3e siêu tốc (7.1 TB/s) của GPU và 496 GB LPDDR5X (396 GB/s) của CPU để tạo thành một pool bộ nhớ duy nhất lên đến 748 GB. Lập trình viên AI không còn phải viết code luân chuyển dữ liệu giữa RAM và VRAM, loại bỏ hoàn toàn các chu kỳ sao chép dư thừa (redundant copying).
-
Transformer Engine Gen 2 và Bước nhảy vọt NVFP4: GB300 khai thác tối đa Lõi Tensor Blackwell Ultra thế hệ mới, tăng tốc độ xử lý lớp attention lên gấp 2 lần và cung cấp lượng FLOPS AI cao hơn 1.5 lần. Đặc biệt, công nghệ mở rộng vi tensor tiên phong ứng dụng chuẩn 4-bit (NVFP4), mang lại hiệu năng 20 PetaFLOPS (lên tới 153 PetaFLOPS thưa). Đột phá này nhân đôi thông lượng và quy mô mô hình mà bộ nhớ có thể chứa đựng, tối ưu hóa tuyệt đối cho các siêu mô hình Hỗn hợp chuyên gia (MoE).
-
Bảo mật Điện toán Cấp phần cứng (Confidential Computing): GB300 là thế hệ GPU đầu tiên trong ngành hỗ trợ môi trường thực thi tin cậy TEE-I/O. Nó bảo vệ dữ liệu nhạy cảm và tài sản trí tuệ (IP) của các mô hình AI bằng mã hóa phần cứng mạnh mẽ ngay trên liên kết NVLink, với điểm đáng giá nhất là thông lượng (throughput) gần như không bị suy giảm so với chế độ không mã hóa.
-
Động cơ Dự đoán và Chẩn đoán Lỗi (RAS Engine): Nhằm đảm bảo thời gian uptime tuyệt đối, nền tảng tích hợp RAS Engine. Công nghệ này dùng chính AI để liên tục giám sát hàng nghìn điểm dữ liệu, cung cấp thông tin chẩn đoán chuyên sâu để dự đoán và cách ly sớm các nguy cơ lỗi trước khi chúng gây ra thời gian chết (downtime).
Bản Thiết Kế Tham Chiếu Định Hình Hệ Sinh Thái Máy Chủ Mới
Nền tảng vi kiến trúc GB300 không chỉ là một khối silicon khép kín, mà đóng vai trò như một “bản thiết kế tham chiếu” (Reference Architecture) hoàn hảo, tạo bệ phóng cho toàn bộ ngành công nghiệp phần cứng.
Bằng việc tự tay giải quyết bài toán phức tạp nhất là giao tiếp liên kết CPU-GPU ngay ở cấp độ vi mạch, NVIDIA đã giải phóng các nhà sản xuất thiết bị gốc (OEM) khỏi những giới hạn thiết kế bo mạch chủ truyền thống. Việc loại bỏ các cụm switch PCIe cồng kềnh giúp đơn giản hóa đáng kể kiến trúc vật lý xung quanh vi xử lý.
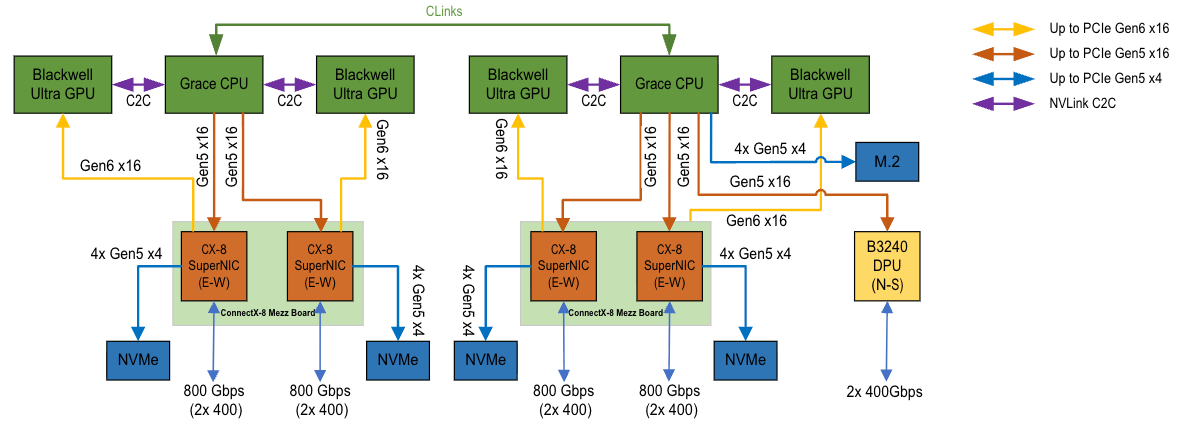
Từ lõi Superchip này, hệ sinh thái phần cứng có thể linh hoạt tùy biến và kiến tạo ra vô số hình thái thiết bị (form factors) đa dạng:
-
Môi trường văn phòng/Lab (Deskside): Xây dựng các siêu máy tính tại bàn ( như DGX Station) với độ ồn thấp, cho phép các kỹ sư R&D tương tác trực tiếp với mô hình tỷ tham số.
-
Hạ tầng quy mô lớn (Data Center): Phát triển các hệ thống máy chủ mật độ cao, tích hợp giải pháp tản nhiệt chất lỏng trực tiếp (Direct-to-Chip Liquid Cooling) tiên tiến nhất (như DGX GB300 NVL 72).
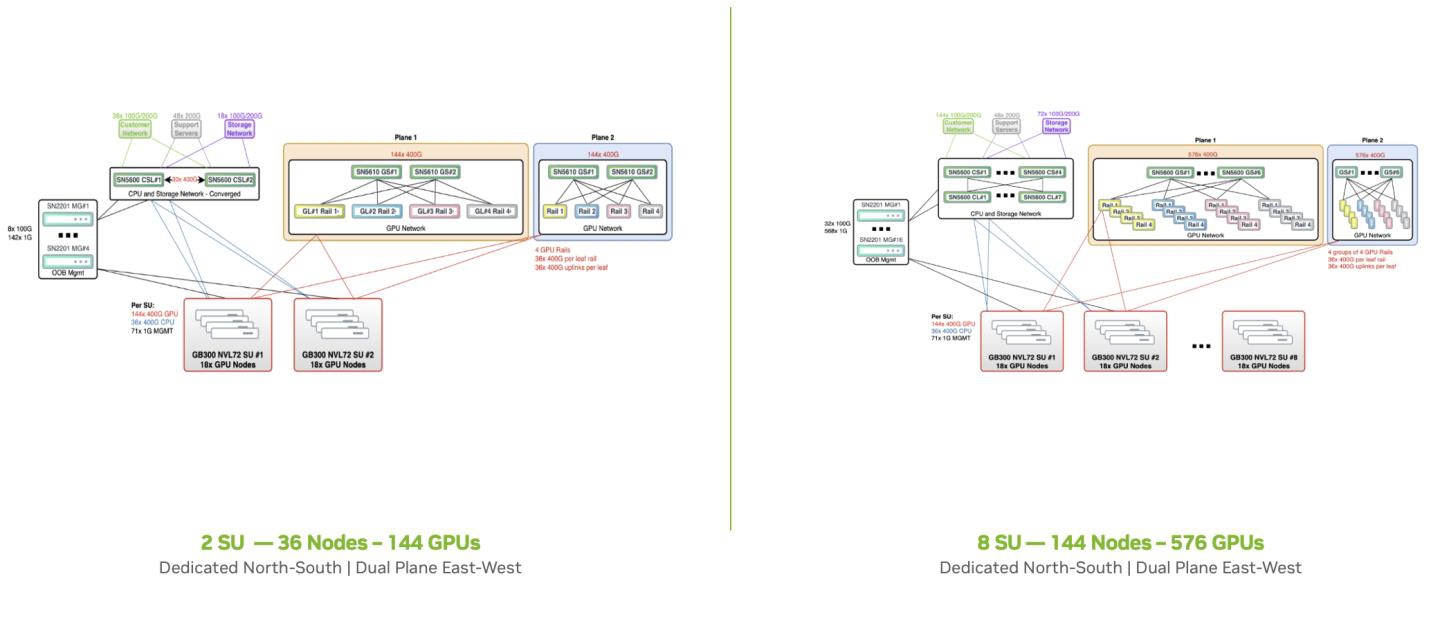
Đặc biệt, nền tảng mang DNA mở rộng (Scale-out) đến mức tối đa. Bằng cách kết hợp NVLink thế hệ 5 (mở rộng lên tới 576 GPU) và NVLink Switch Chip (băng thông mạng nội bộ 130 TB/s), các cụm máy chủ GB300 có thể ghép nối thành các siêu hệ thống như miền NVL72. Kiến trúc này mang lại thông lượng GPU cao gấp 9 lần so với cụm 8-GPU truyền thống.
Kết quả của bản thiết kế tham chiếu này là một bài toán kinh tế không thể chối từ: GB300 cung cấp hiệu năng suy luận cao hơn tới 50 lần và chi phí thấp hơn 35 lần cho các khối lượng công việc Agentic AI. Đây chính là lý do các gã khổng lồ đám mây như Microsoft, CoreWeave và Oracle (OCI) đang đồng loạt triển khai hệ thống GB300 NVL72 ở quy mô khổng lồ, chính thức mở ra kỷ nguyên mới cho hạ tầng điện toán AI toàn cầu.
GB300 Grace Blackwell Ultra Superchip không chỉ đơn thuần đẩy cao mức trần hiệu năng, mà đang chuẩn hóa một chuẩn mực mới cho hạ tầng điện toán tăng tốc. Thay vì chỉ mở rộng dung lượng theo cách thức truyền thống, kiến trúc này tối ưu triệt để luồng vận chuyển dữ liệu qua sự cộng sinh giữa CPU Grace và GPU Blackwell Ultra, mang đến mật độ tính toán và hiệu quả năng lượng vượt trội trên từng chu kỳ xử lý. Đây chính là bệ phóng hạ tầng vững chắc để doanh nghiệp tự chủ triển khai các hệ thống tác nhân AI (Agentic AI) tự hành và vận hành các siêu mô hình ngôn ngữ quy mô lớn với độ trễ tối thiểu cùng hiệu quả kinh tế tối ưu.
-
Quý doanh nghiệp đang tìm kiếm các giải pháp máy chủ điện toán AI kiến trúc mới nhất được xây dựng trên nền tảng Grace Blackwell Superchip?
-
Cần tư vấn chuyên sâu về thiết kế hạ tầng trung tâm dữ liệu sử dụng hệ sinh thái đa tầng của NVIDIA?
Hãy liên hệ ngay với đội ngũ chuyên gia của Nhất Tiến Chung để được tư vấn. Với cương vị là NVIDIA Elite Partner tại Việt Nam, chúng tôi sẽ đồng hành phân tích kiến trúc và kiến tạo nên những hệ thống hạ tầng nền tảng GB300 tối ưu nhất cho doanh nghiệp của bạn!