NVIDIA Vera Rubin POD: Kiến trúc Siêu Máy Tính AI – Hợp Nhất 5 Hệ Thống Rack Cho Kỷ Nguyên Agentic AI
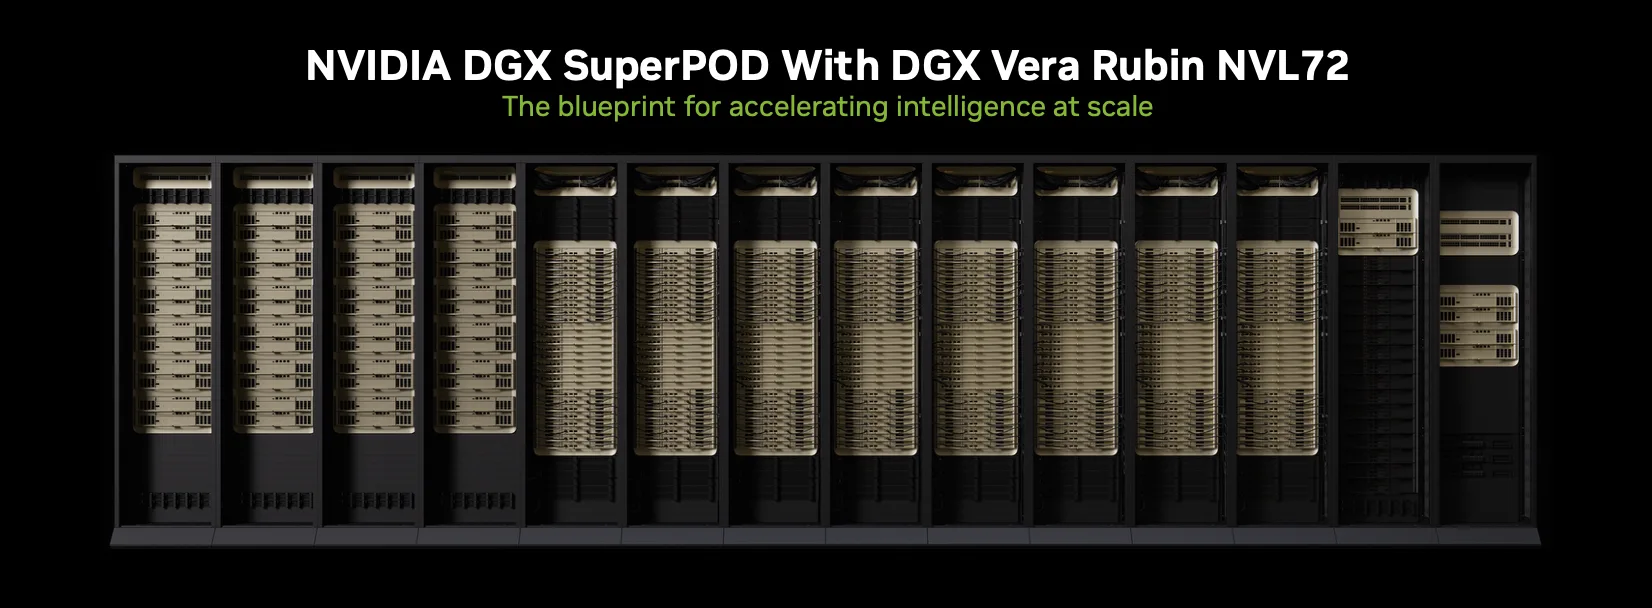
Trí tuệ nhân tạo (AI) đã chính thức bước vào giai đoạn công nghiệp hóa, chuyển dịch từ các hệ thống huấn luyện mô hình rời rạc sang những nhà máy AI vận hành liên tục để chuyển hóa điện năng, vi mạch và dữ liệu thành tri thức ở quy mô lớn. Trong vòng một năm qua, mức tiêu thụ token toàn cầu đã tăng trưởng gấp nhiều lần và vượt ngưỡng 10 triệu tỷ token mỗi năm. Đáng chú ý, trọng tâm của lưu lượng này đang dịch chuyển mạnh mẽ từ tương tác giữa con người với AI sang kỷ nguyên mà phần lớn token được sinh ra từ quá trình các hệ thống AI tự động tương tác lẫn nhau.
Các hệ thống tác tử tự hành (AI Agents) hiện đại có khả năng lập kế hoạch tác vụ, gọi công cụ, thực thi mã nguồn, truy xuất dữ liệu và phối hợp xuyên suốt các quy trình đa bước. Cơ chế vận hành này tạo ra khối lượng khổng lồ token suy luận, làm phình to bộ nhớ đệm ngữ cảnh KV Cache và đòi hỏi các môi trường hộp cát (Sandbox) trên CPU để kiểm thử, xác thực kết quả từ các hệ thống điện toán tăng tốc. Áp lực đó đặt ra yêu cầu đồng thời về độ trễ siêu thấp và thông lượng cực cao xuyên suốt toàn bộ hạ tầng, từ GPU, CPU, miền kết nối nội cụm cho đến mạng mở rộng liên cụm và hệ thống lưu trữ.
Ad
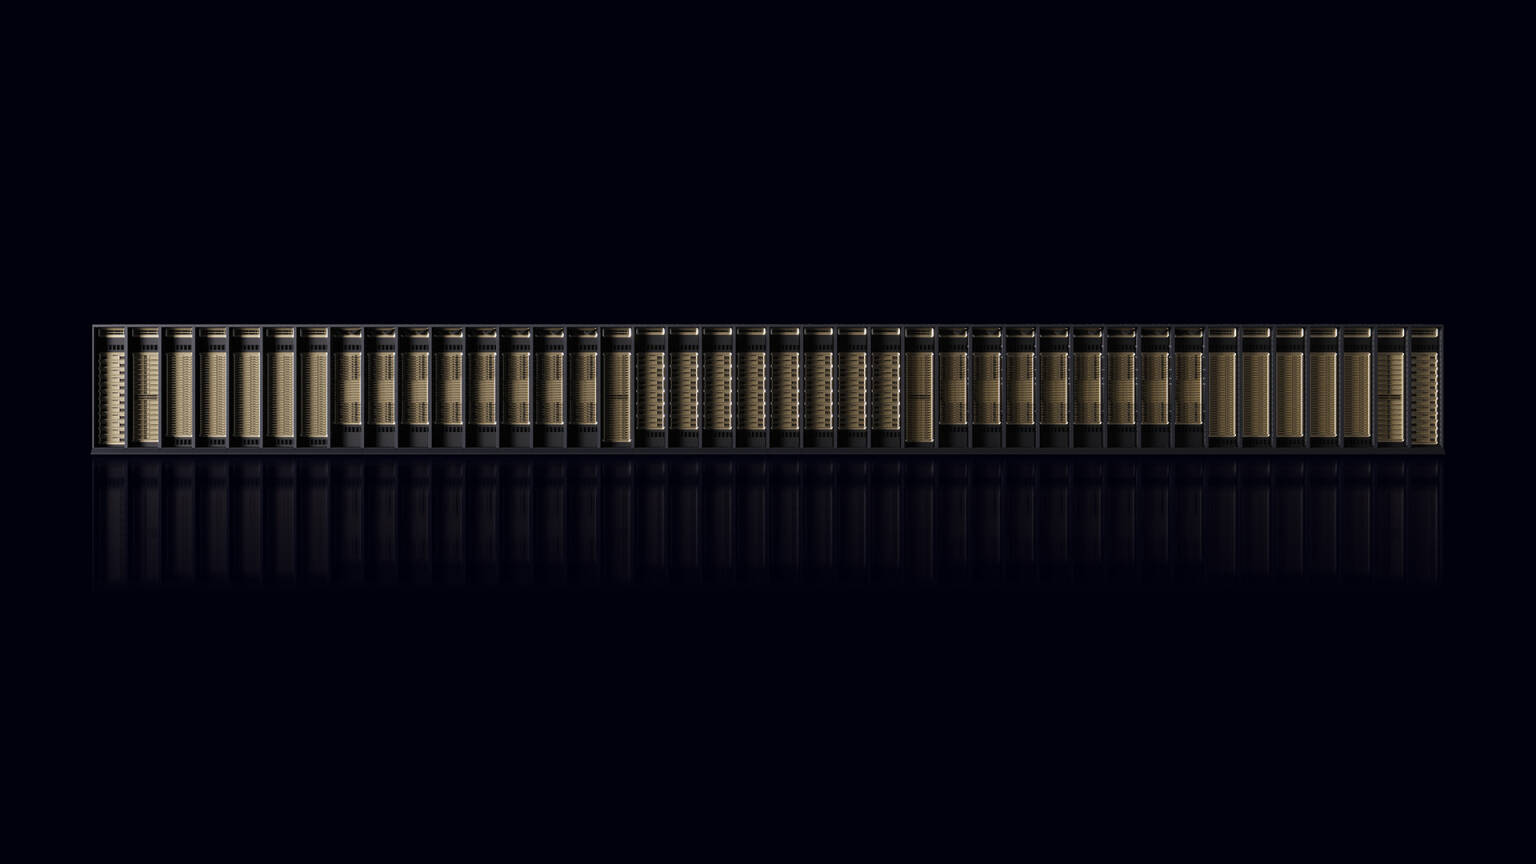
Để đáp ứng trọn vẹn bài toán này, NVIDIA đã phát triển nền tảng NVIDIA Vera Rubin POD dựa trên triết lý đồng thiết kế chuyên sâu từ vi mạch, mạng, bảo mật, phần mềm cho đến hệ thống cấp nguồn và làm mát, coi toàn bộ trung tâm dữ liệu là một đơn vị tính toán thống nhất thay vì các máy chủ riêng lẻ. Giải pháp hợp nhất 7 dòng chip mới vào 5 hệ thống tủ rack chuyên biệt trên nền tảng giá đỡ NVIDIA MGX thế hệ thứ ba:
-
Quy mô hợp nhất cấp độ siêu máy tính: Toàn bộ tổ hợp NVIDIA Vera Rubin POD bao gồm 40 tủ rack, quy tụ 1,2 triệu tỷ bóng bán dẫn, gần 20.000 đế bán dẫn NVIDIA, 1.152 GPU NVIDIA Rubin, đạt hiệu năng tính toán 60 exaflops cùng tổng băng thông mở rộng nội cụm lên tới 10 PB/s.
-
Kiến trúc giá đỡ NVIDIA MGX thế hệ thứ ba chuẩn hóa: Được thiết kế theo tiêu chuẩn mở đóng góp cho tổ chức Open Compute Project (OCP) với sự hậu thuẫn của hệ sinh thái hơn 80 đối tác toàn cầu, tất cả các tủ rack trong POD đều dùng chung thông số cơ khí, cấp nguồn và làm mát để triển khai đồng bộ.
-
Hai dòng khung tủ rack xương sống đồng chuyên biệt: Hạ tầng MGX thế hệ mới gồm tủ rack MGX NVL sử dụng kết nối NVIDIA NVLink và tủ rack MGX ETL hỗ trợ tùy chọn trục kết nối NVIDIA Spectrum-X Ethernet hoặc liên kết trực tiếp chip-tới-chip NVIDIA Groq 3 LPU.
Năm Hệ Thống Tủ Rack Chuyên Biệt Trong Hệ Sinh Thái Vera Rubin POD
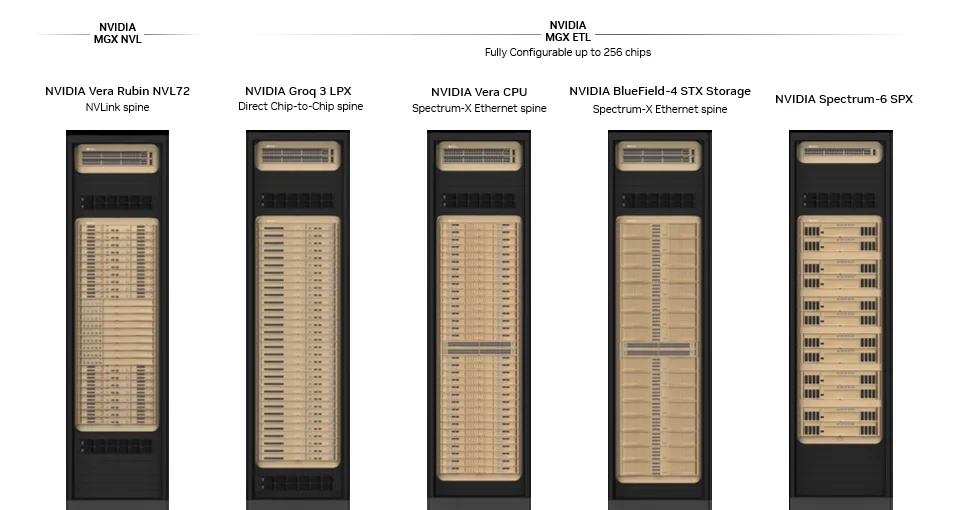
Mỗi khối lượng công việc trong quy trình Agentic AI đều đòi hỏi sự cân bằng đặc thù giữa năng lực tính toán song song, độ trễ phản hồi tức thời, môi trường thực thi hộp cát và băng thông truy xuất ngữ cảnh. Thay vì ép mọi tác vụ lên một cấu hình phần cứng đồng nhất, NVIDIA Vera Rubin POD phân tách hạ tầng thành năm hệ thống tủ rack chuyên biệt phối hợp chặt chẽ như một siêu máy tính thống nhất:
-
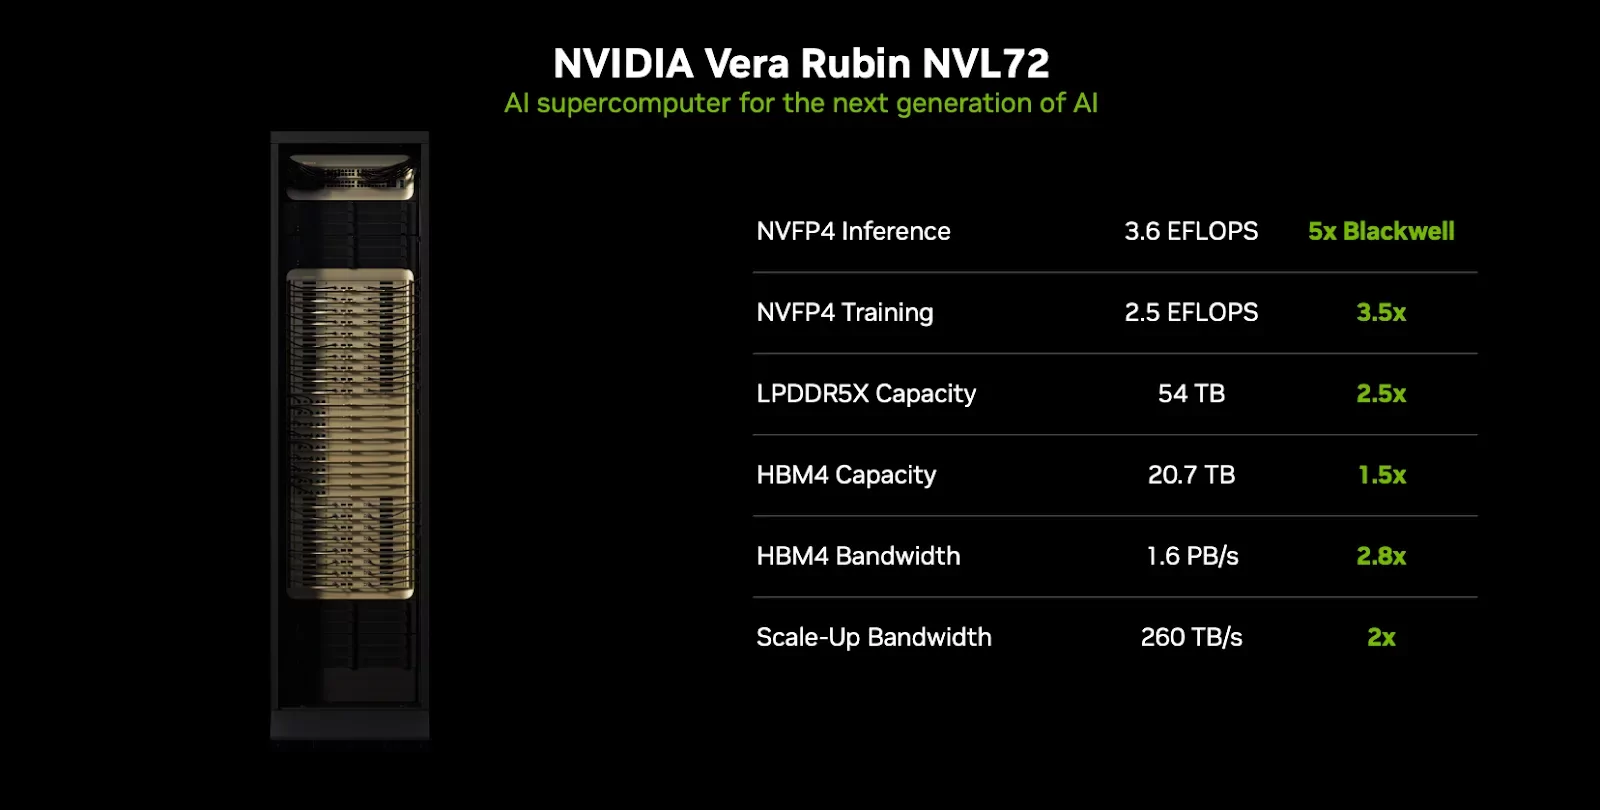
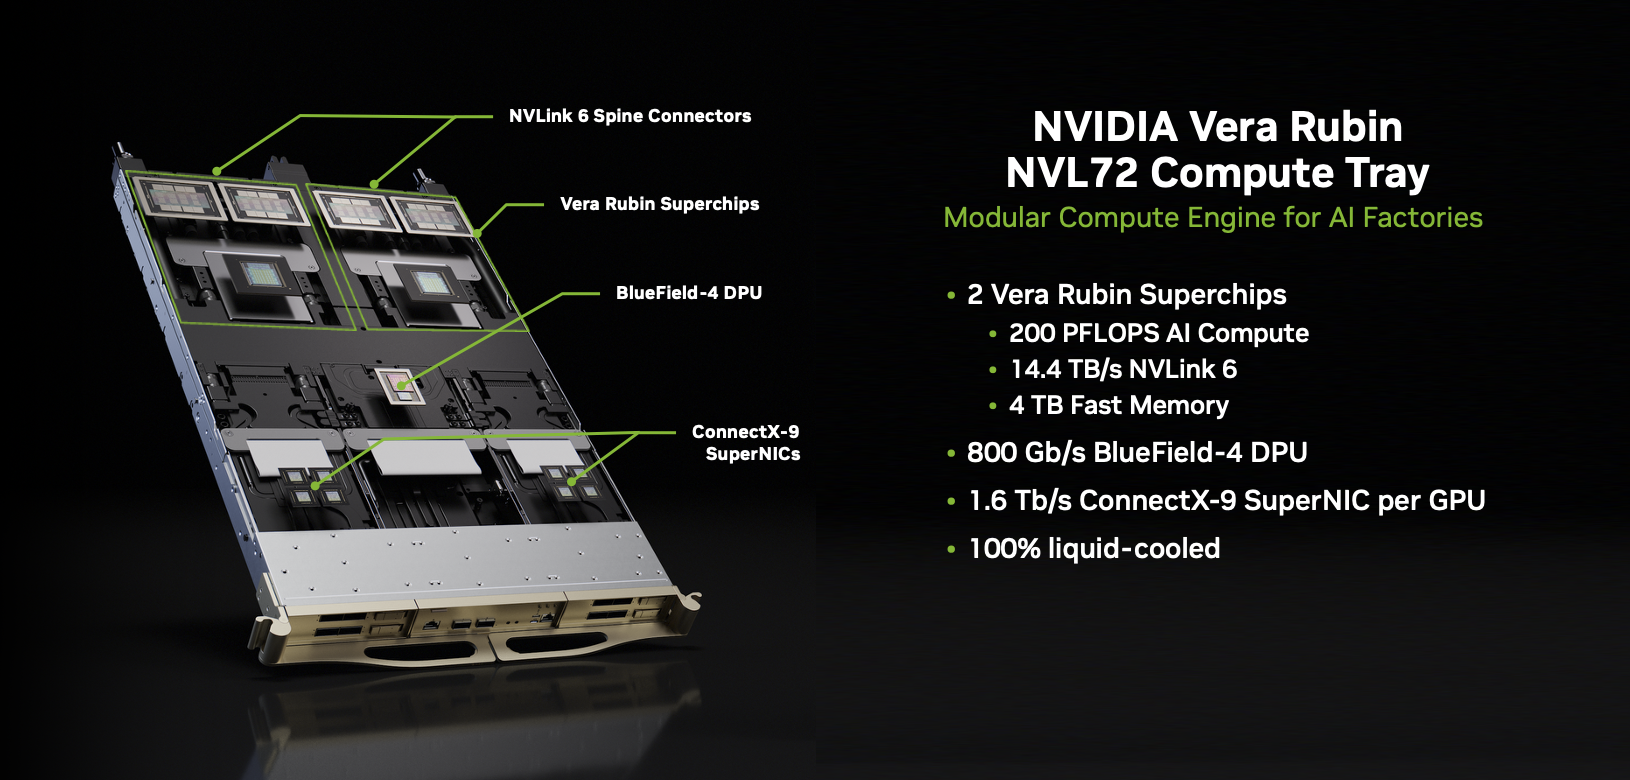
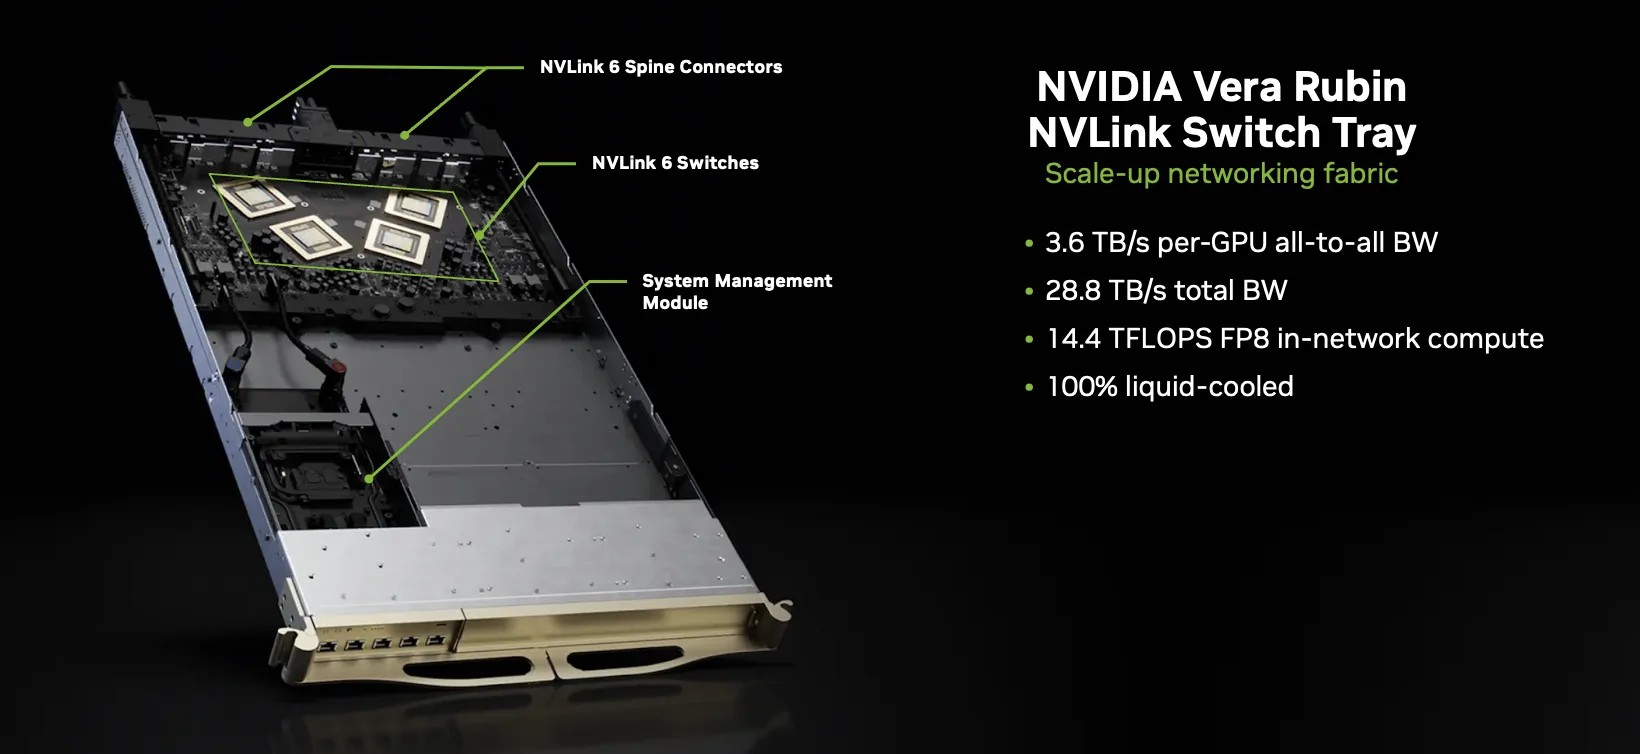
NVIDIA Vera Rubin NVL72 – Động cơ tính toán cốt lõi cho bốn quy luật mở rộng AI: Được xây dựng trên khung tủ rack đơn rộng 19 inch nặng khoảng 4.000 lbs với 1,3 triệu linh kiện và gần 1.300 vi xử lý, hệ thống bao gồm 18 khay tính toán và 9 khay chuyển mạch NVLink 6. Mỗi khay tính toán dạng mô-đun tích hợp hai siêu chip NVIDIA Vera Rubin với 17.000 linh kiện mỗi siêu chip ở phía sau, kết nối qua bảng mạch trung gian PCB tới khoang mô-đun phía trước chứa tám card mạng ConnectX-9 SuperNIC và một bộ xử lý BlueField-4 DPU, giúp rút ngắn thời gian lắp ráp và bảo trì khay xuống chỉ còn 5 phút. Ở tầng kết nối, mỗi khay chuyển mạch chứa bốn chip NVLink 6 Switch liên kết với trục cáp đồng phía sau gồm bốn hộp cáp mô-đun tích hợp 5.000 sợi cáp đồng dài hơn hai dặm, cung cấp băng thông nội tủ 260 TB/s để 72 GPU Rubin và 36 CPU Vera vận hành như một bộ tăng tốc duy nhất. Thiết kế này tối ưu cho cả tiền huấn luyện, hậu huấn luyện, mở rộng thời gian kiểm thử, mở rộng tác tử và định tuyến Mixture-of-Experts (MoE), đạt hiệu năng huấn luyện cao hơn tới 4 lần, hiệu năng suy luận trên mỗi watt cao hơn tới 10 lần và giảm chi phí token xuống còn một phần mười so với Blackwell.
-
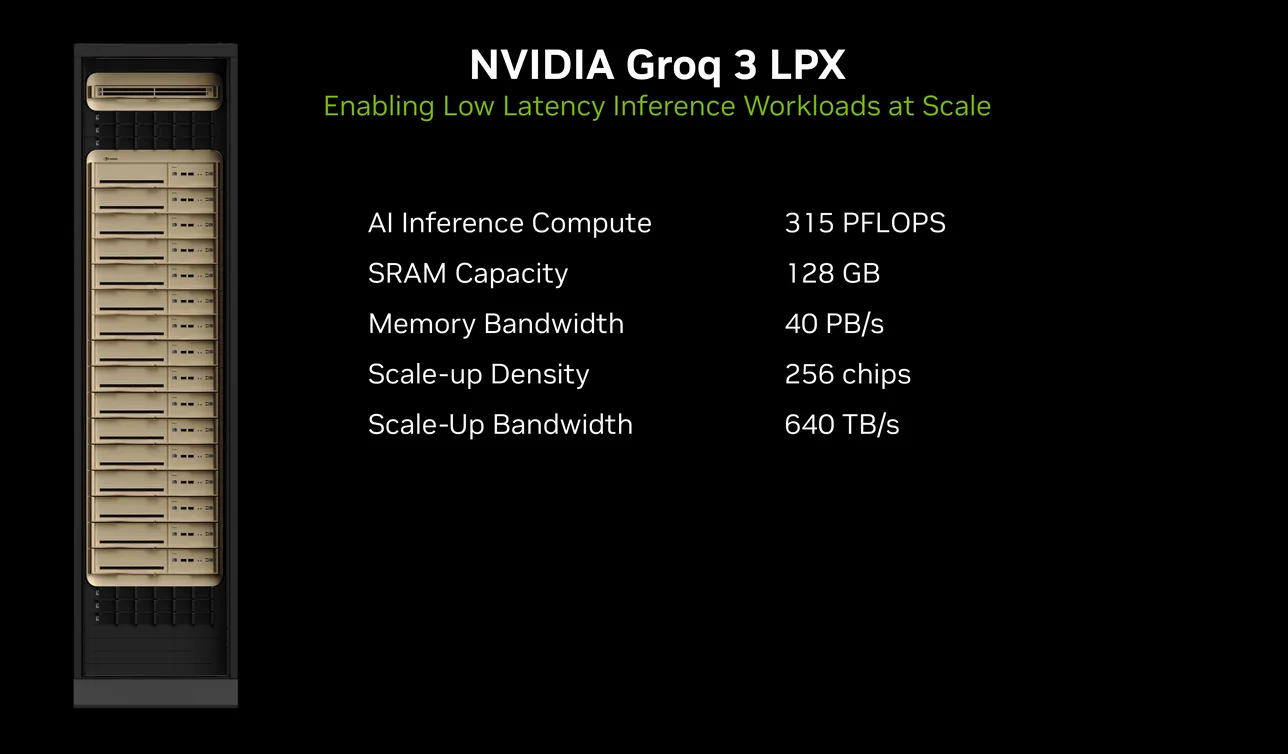
NVIDIA Groq 3 LPX – Tủ rack tăng tốc suy luận độ trễ siêu thấp: Phát triển trên kiến trúc khung MGX ETL với trục kết nối trực tiếp chip-tới-chip gồm hai hộp cáp đồng chứa hàng nghìn cặp cáp điểm-tới-điểm, mỗi tủ rack LPX quy tụ 32 khay tính toán với tám bộ xử lý ngôn ngữ LPU trên mỗi khay, tạo thành tổ hợp 256 LPU vận hành như một động cơ suy luận duy nhất. Khi ghép cặp cùng Vera Rubin NVL72, giải pháp kết hợp các LPU thuần bộ nhớ SRAM băng thông cao với GPU Rubin sở hữu dung lượng HBM4 lớn, loại bỏ sự đánh đổi giữa tốc độ tương tác tức thời và thông lượng xử lý ở độ dài ngữ cảnh lớn. Tổ hợp Vera Rubin NVL72 kết hợp LPX tạo ra lượng token cao hơn tới 35 lần và mở rộng cơ hội doanh thu gấp 10 lần cho các mô hình nghìn tỷ tham số so với Blackwell, đồng thời duy trì liên kết trực tiếp xuyên suốt khi mở rộng nhiều tủ rack LPX cùng lúc.
-
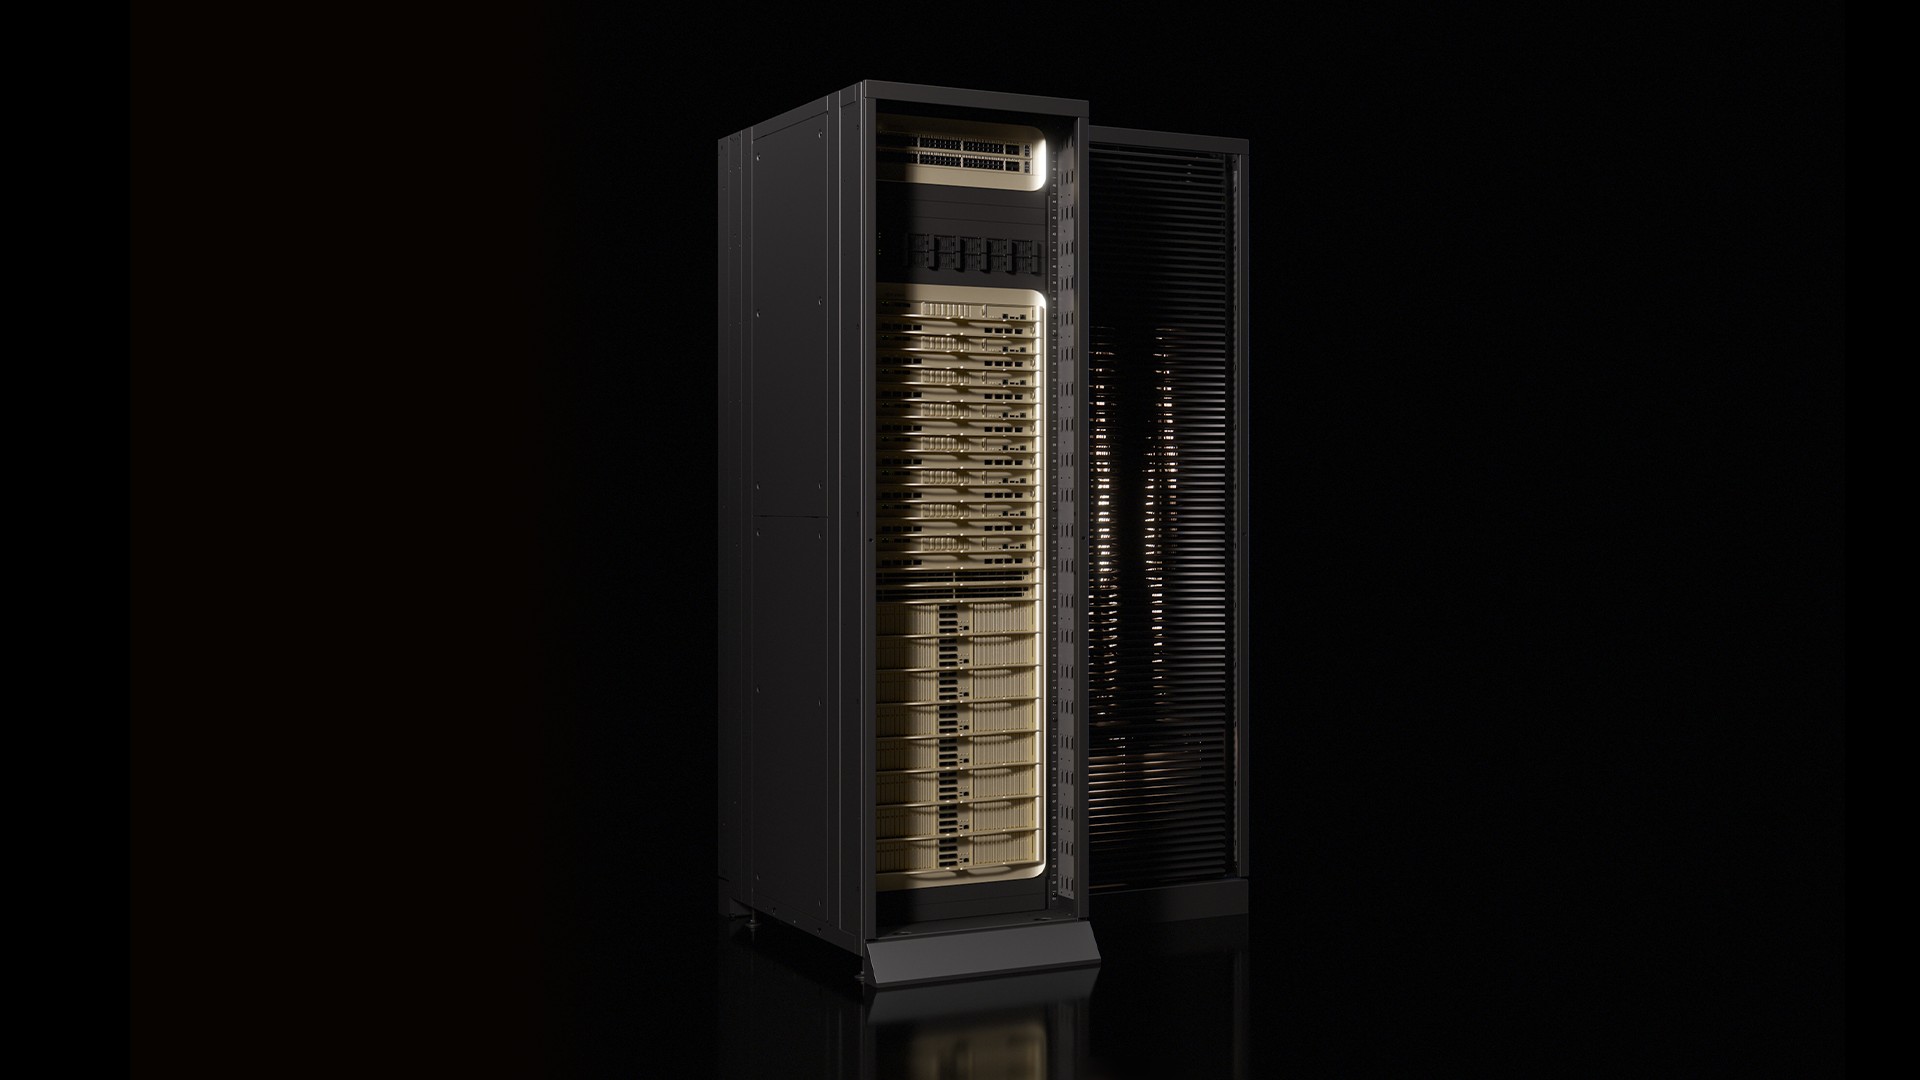
NVIDIA Vera CPU Rack – Tủ rack học tăng cường và môi trường hộp cát quy mô lớn: Được cấu hình trên khung tủ rack làm mát bằng chất lỏng MGX ETL với trục kết nối Spectrum-X Ethernet, mỗi tủ rack tích hợp tới 256 CPU NVIDIA Vera mật độ cao. Hệ thống có khả năng duy trì đồng thời hơn 22.500 môi trường học tăng cường (RL) hoặc môi trường hộp cát tác tử để kiểm thử, thực thi và xác thực các kết quả được sinh ra từ cụm Vera Rubin NVL72 và LPX, đạt hiệu suất năng lượng cao gấp đôi và tốc độ xử lý nhanh hơn 50% so với các hệ thống CPU dạng rack truyền thống.
-
NVIDIA BlueField-4 STX – Tủ rack lưu trữ thuần AI với nền tảng bộ nhớ ngữ cảnh: Xây dựng trên khung MGX ETL kết hợp bộ xử lý BlueField-4 và mạng mở rộng Spectrum-X Ethernet, tủ rack BlueField-4 STX vận hành nền tảng lưu trữ bộ nhớ ngữ cảnh NVIDIA CMX và kiến trúc NVIDIA Inference Context Memory Storage (ICMS). Giải pháp thiết lập tầng lưu trữ flash gắn mạng Ethernet chuyên biệt gọi là tầng G3.5 với dung lượng lên tới mức Petabyte trên mỗi cụm POD, nằm giữa bộ nhớ cục bộ của GPU và hệ thống lưu trữ bền vững truyền thống. Nhờ chuyển tải KV Cache vào tầng G3.5 thông qua giao thức NVMe-over-Fabrics và RDMA do BlueField-4 xử lý độc lập, ngữ cảnh tạm thời trở thành tài nguyên dùng chung có thể tái sử dụng xuyên suốt nhiều lượt hội thoại, phiên làm việc và tác tử, mang lại số token mỗi giây cao hơn tới 5 lần và hiệu suất năng lượng gấp 5 lần so với lưu trữ truyền thống.
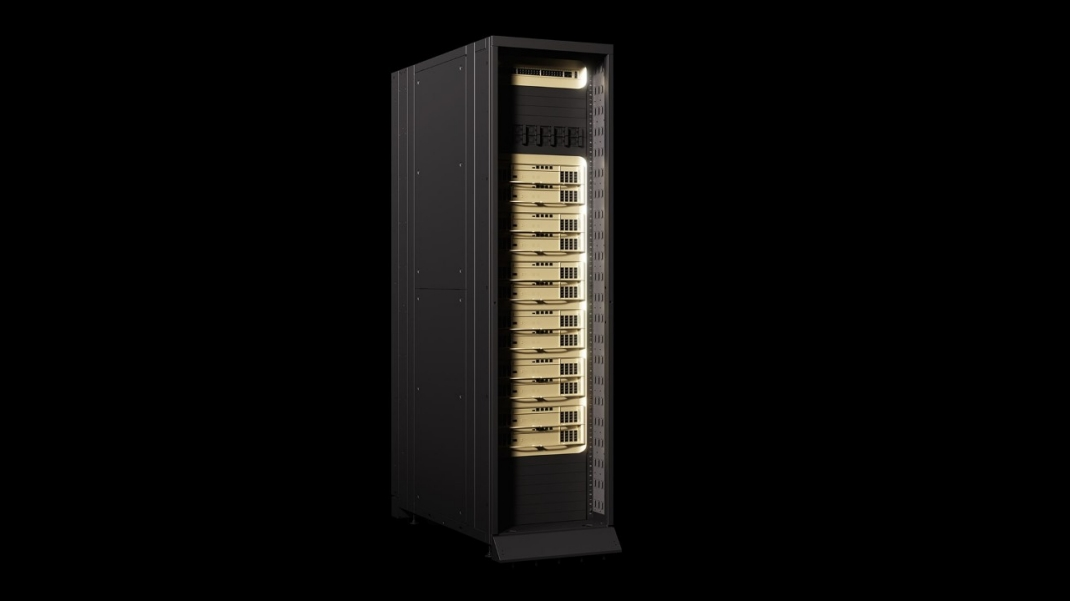
- NVIDIA Spectrum-6 SPX – Tủ rack mạng đồng bộ kết nối toàn cụm POD: Đảm nhiệm vai trò liên kết toàn bộ các tủ rack thành một siêu máy tính thống nhất, Spectrum-6 SPX điều phối cả lưu lượng nội cụm lẫn liên cụm với tùy chọn thiết bị chuyển mạch Spectrum-X Ethernet hoặc NVIDIA Quantum-X800 InfiniBand. Trên các tủ rack MGX ETL vốn có khả năng cấu hình linh hoạt tới 256 GPU Rubin dạng HGX Rubin NVL8 hoặc XPU, các khay chuyển mạch 1U Spectrum-6 đặt tại trung tâm tủ kết nối mặt sau trực tiếp với trục cáp đồng và mặt trước qua 32 cổng quang OSFP để liên kết tới phần còn lại của POD. Nhờ cấu trúc liên kết Spectrum-X Multiplane phân tách các làn 200 Gb/s qua nhiều bộ chuyển mạch và công nghệ Spectrum-XGS Ethernet kiểm soát tắc nghẽn theo khoảng cách, hệ thống duy trì kết nối không biến thiên độ trễ giữa các tủ rack và giữa các trung tâm dữ liệu phân tán về mặt địa lý.
Nền Tảng Vi Xử Lý Lõi – 7 Dòng Chip Chuyên Biệt và Siêu Chip NVIDIA Vera Rubin
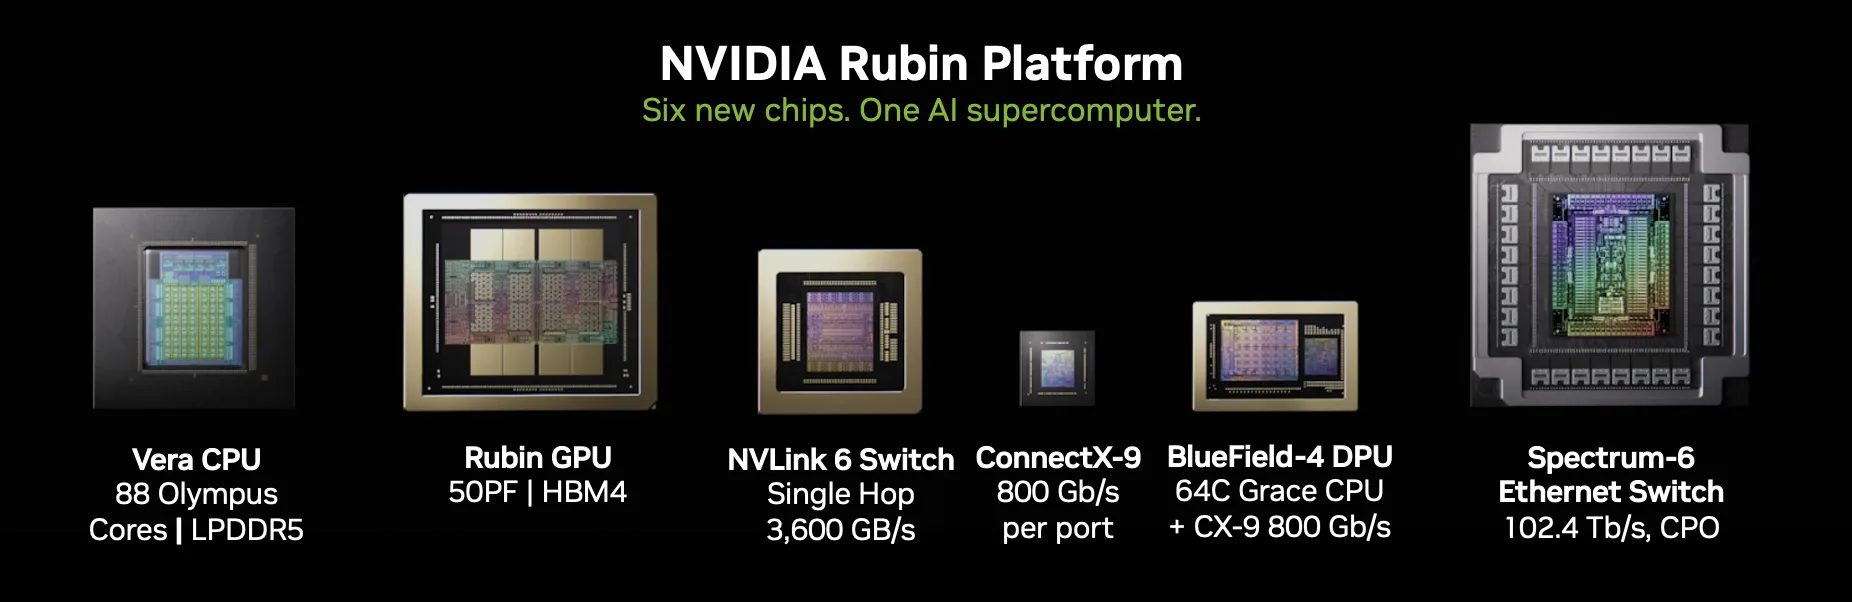
Triết lý đồng thiết kế của NVIDIA Vera Rubin POD được hiện thực hóa trước hết ở cấp độ vi mạch, nơi 7 dòng chip thế hệ mới được chế tạo để vận hành đồng bộ như một hệ thống thống nhất thay vì các lớp phần cứng rời rạc. Trong kiến trúc này, mỗi vi xử lý đảm nhiệm một vai trò chuyên biệt từ thực thi tính toán, điều phối dữ liệu, kết nối nội cụm và liên cụm cho đến quản trị hạ tầng và suy luận độ trễ siêu thấp:
-
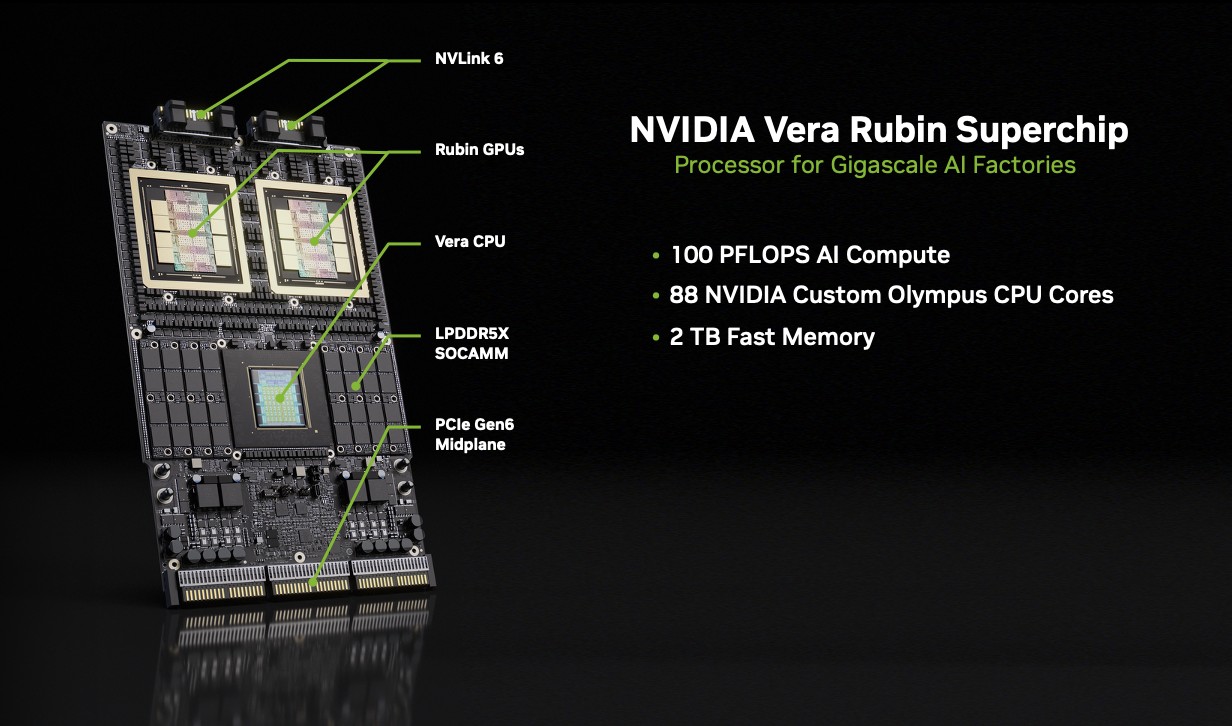
Siêu chip NVIDIA Vera Rubin Superchip: Đóng vai trò là khối xây dựng tính toán trung tâm của toàn nền tảng, mỗi siêu chip kết hợp hai GPU Rubin với một CPU Vera trên cùng một bo mạch xử lý chủ thông qua giao tiếp bộ nhớ nhất quán NVLink-C2C đạt băng thông hai chiều 1,8 TB/s. Sự hợp nhất này cho phép CPU và GPU truy cập chung một không gian địa chỉ bộ nhớ thống nhất giữa LPDDR5X và HBM4, giảm thiểu độ trễ luân chuyển dữ liệu và duy trì hiệu suất khai thác phần cứng ổn định qua mọi pha tính toán.
-
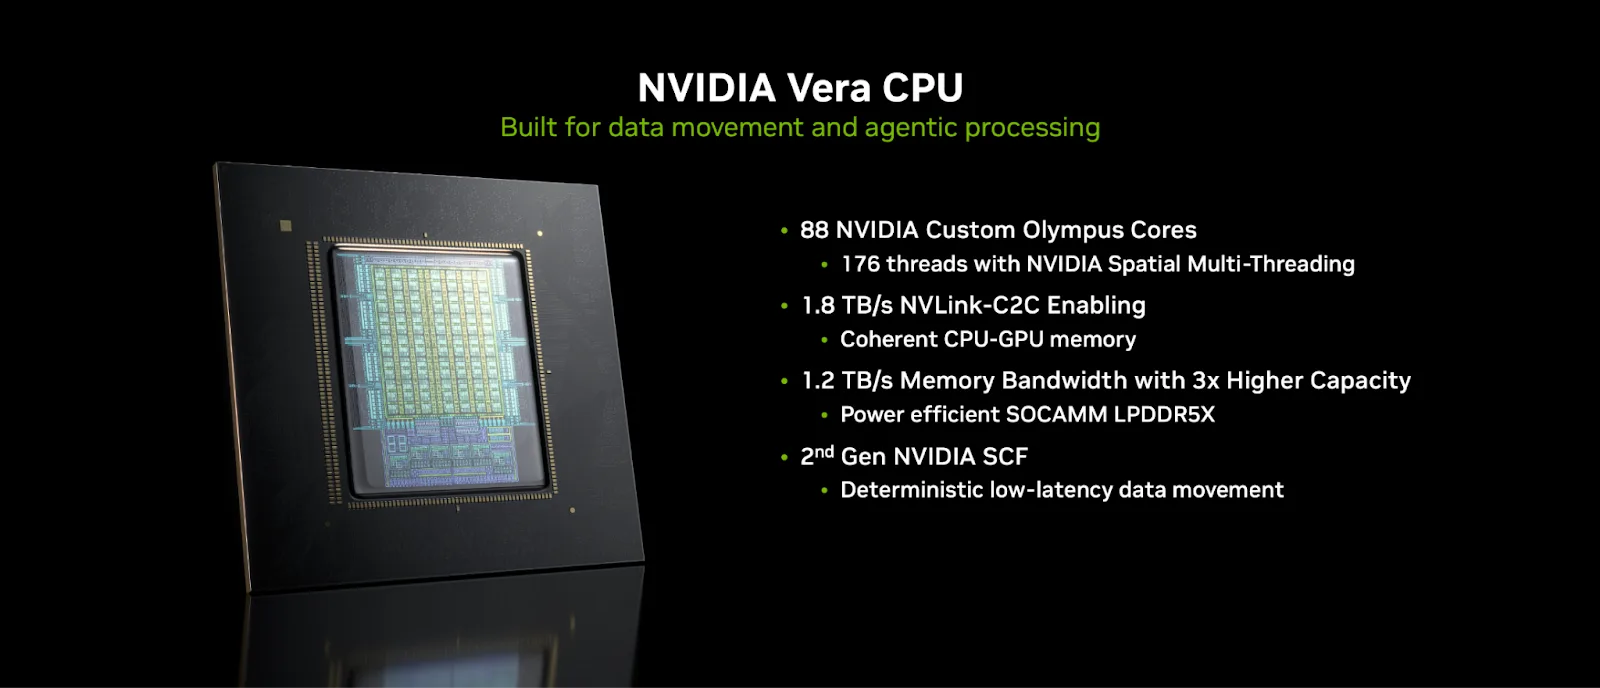
Bộ xử lý NVIDIA Vera CPU: Được thiết kế chuyên biệt làm động cơ điều phối và luân chuyển dữ liệu cho các nhà máy AI, Vera CPU tích hợp 88 nhân tùy biến Olympus tương thích kiến trúc Arm v9.2 cùng công nghệ đa luồng không gian Spatial Multithreading cho phép chạy hai luồng phần cứng độc lập trên mỗi nhân, nâng tổng năng lực xử lý lên 176 luồng. Toàn bộ nhân xử lý được kết nối với bộ nhớ đệm L3 dùng chung 164MB thông qua kết cấu nhất quán thế hệ thứ hai Scalable Coherency Fabric (SCF) giúp duy trì trên 90% băng thông đỉnh ngay cả khi chịu tải nặng. Vi xử lý hỗ trợ tới 1,5TB bộ nhớ LPDDR5X dạng mô-đun Small Outline Compression Attached Memory Modules (SOCAMM) với băng thông đạt 1,2 TB/s, tăng gấp 2,4 lần băng thông và gấp 3 lần dung lượng bộ nhớ so với thế hệ Grace CPU, đồng thời hỗ trợ chuẩn giao tiếp PCIe Gen6 và CXL 3.1.
-
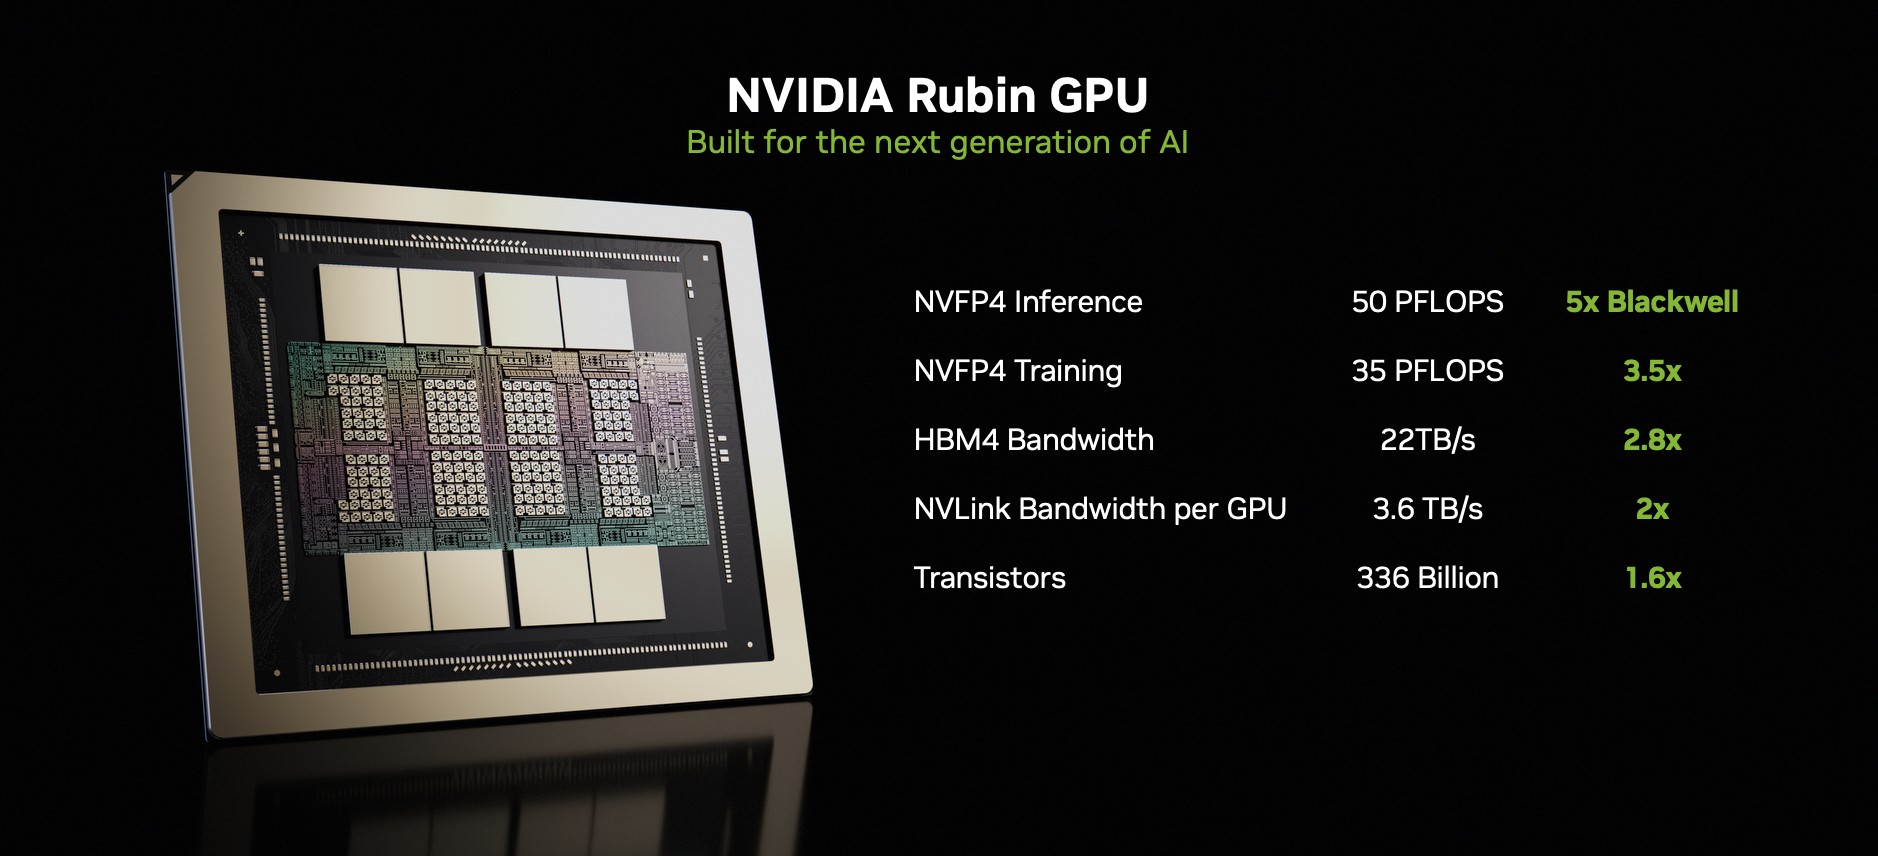
Bộ tăng tốc NVIDIA Rubin GPU: Đóng vai trò là động cơ thực thi chính cho kỷ nguyên mô hình Transformer, mỗi GPU Rubin quy tụ 336 tỷ bóng bán dẫn trên hai đế tính toán với 224 nhân xử lý Streaming Multiprocessors (SM) trang bị nhân Tensor thế hệ thứ năm tối ưu cho định dạng chính xác thấp NVFP4 và FP8. Kết hợp cùng bộ tăng tốc Transformer Engine thế hệ thứ ba tích hợp nén thích ứng bằng phần cứng, mỗi GPU đạt hiệu năng suy luận 50 PFLOPS và huấn luyện 35 PFLOPS ở định dạng NVFP4, đồng thời cung cấp năng lực tính toán ma trận 400 TFLOPS FP32 và 200 TFLOPS FP64 cho các bài toán mô phỏng khoa học hội tụ. Hệ thống bộ nhớ thế hệ mới 288GB HBM4 mang lại băng thông lên tới 22 TB/s, cao gần gấp ba lần so với kiến trúc Blackwell để đáp ứng các tác vụ suy luận ngữ cảnh dài.
-
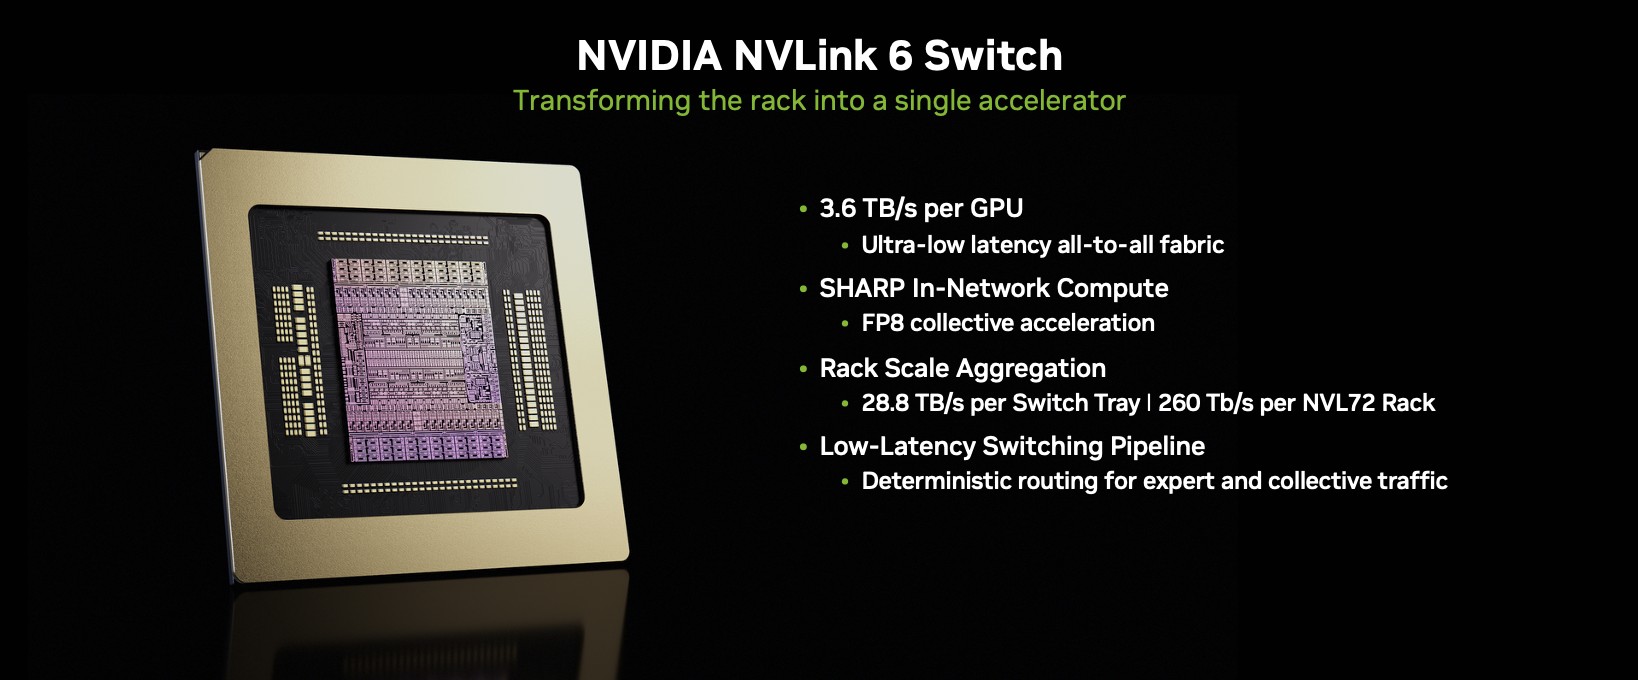
Chip chuyển mạch NVIDIA NVLink 6 Switch: Là kết cấu mạng mở rộng nội cụm thế hệ thứ sáu, NVLink 6 cung cấp băng thông hai chiều 3,6 TB/s cho mỗi GPU Rubin, gấp đôi thế hệ trước nhằm tạo ra mạng lưới kết nối toàn diện đồng đều giữa các GPU. Đặc biệt, chip tích hợp công nghệ tính toán ngay trong mạng lưới Scalable Hierarchical Aggregation and Reduction Protocol (SHARP) với hiệu năng 14,4 TFLOPS FP8 trên mỗi khay chuyển mạch, giúp giảm tới 50% lưu lượng giao tiếp all-reduce và rút ngắn tới 20% thời gian thực thi song song tensor.
-
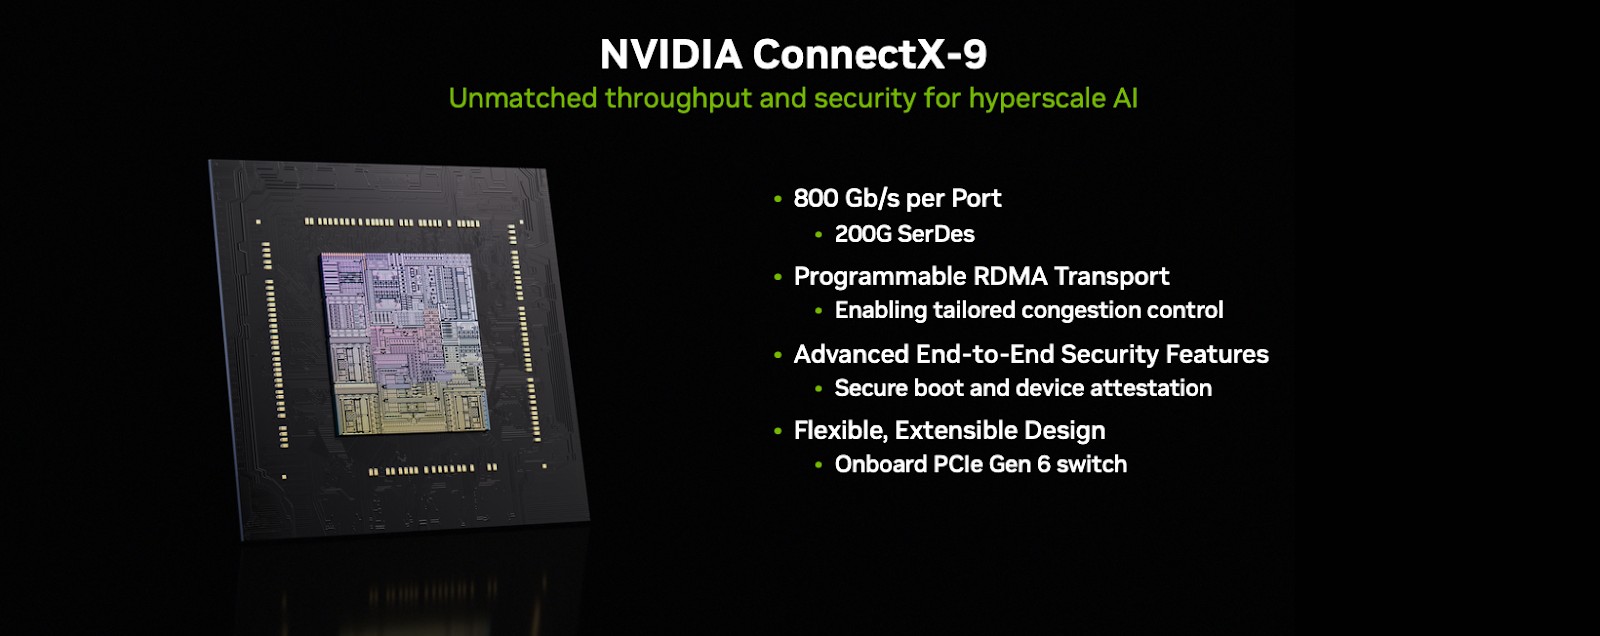
Card mạng thông minh NVIDIA ConnectX-9 SuperNIC: Đảm nhiệm vai trò điểm cuối thông minh cho hạ tầng mạng mở rộng Spectrum-X Ethernet, cấu hình bốn chip ConnectX-9 SuperNIC cung cấp tổng băng thông mạng lên tới 1,6 Tb/s cho mỗi GPU Rubin. Vi mạch chủ động kiểm soát tắc nghẽn, điều tiết lưu lượng và lập lịch gói tin ngay tại điểm cuối để làm mượt các đợt bùng phát dữ liệu trong huấn luyện và suy luận phân tán, đồng thời tích hợp bộ tăng tốc mã hóa phần cứng chuẩn IP Security (IPsec) và Platform Security Protocol (PSP) nhằm bảo vệ dữ liệu truyền tải giữa các GPU mà không làm suy giảm thông lượng.
-
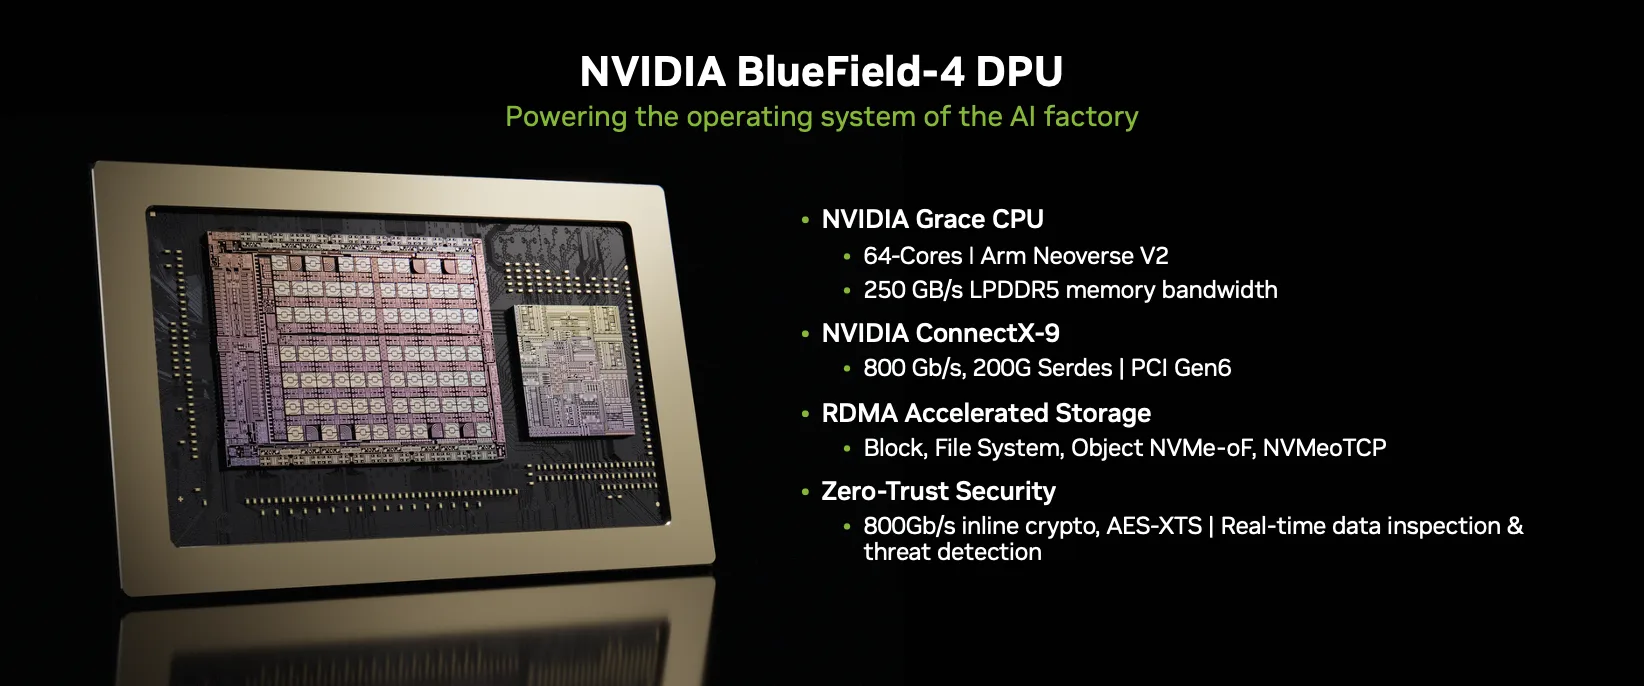
Bộ xử lý dữ liệu NVIDIA BlueField-4 DPU: Đóng vai trò vận hành lớp hạ tầng điều khiển độc lập cho nhà máy AI, mỗi bộ xử lý Data Processing Unit (DPU) BlueField-4 sở hữu cấu trúc đế kép kết hợp một CPU Grace 64 nhân Neoverse V2 với chip mạng ConnectX-9 và 128GB bộ nhớ LPDDR5X đạt băng thông 250 GB/s. Thiết bị cung cấp kết nối Ethernet hoặc InfiniBand tốc độ 800 Gb/s, năng lực phân tách lưu trữ NVMe đạt 20 triệu IOPS ở kích thước khối 4K và giải phóng hoàn toàn các tác vụ mạng, lưu trữ, giám sát đo lường lẫn bảo mật khỏi CPU chủ thông qua bộ khung phần mềm NVIDIA DOCA cùng kiến trúc tin cậy phần cứng Advanced Secure Trusted Resource Architecture (ASTRA).
-
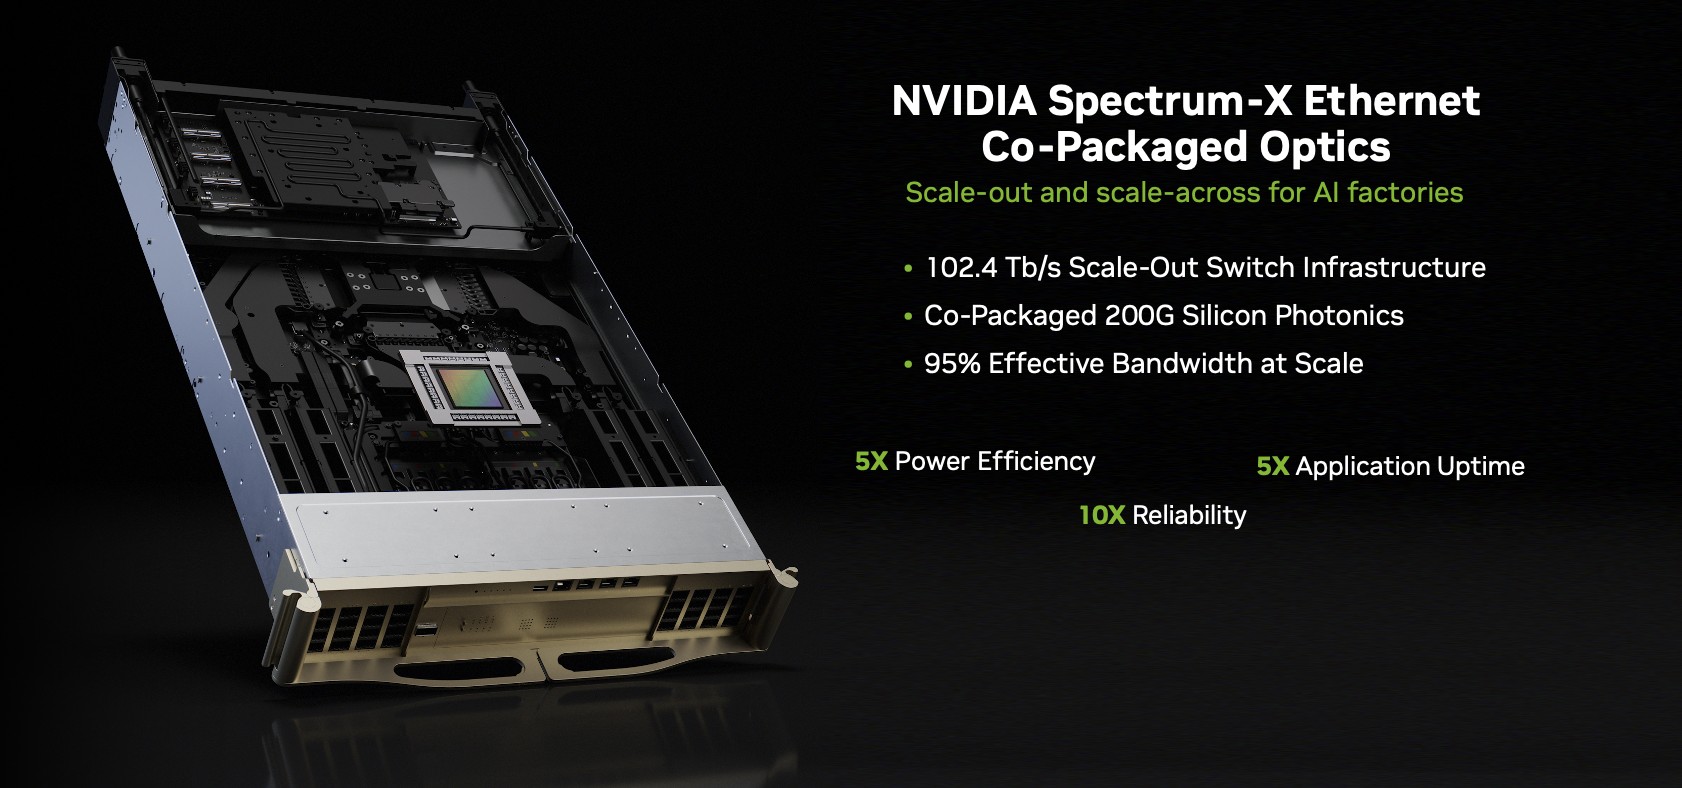
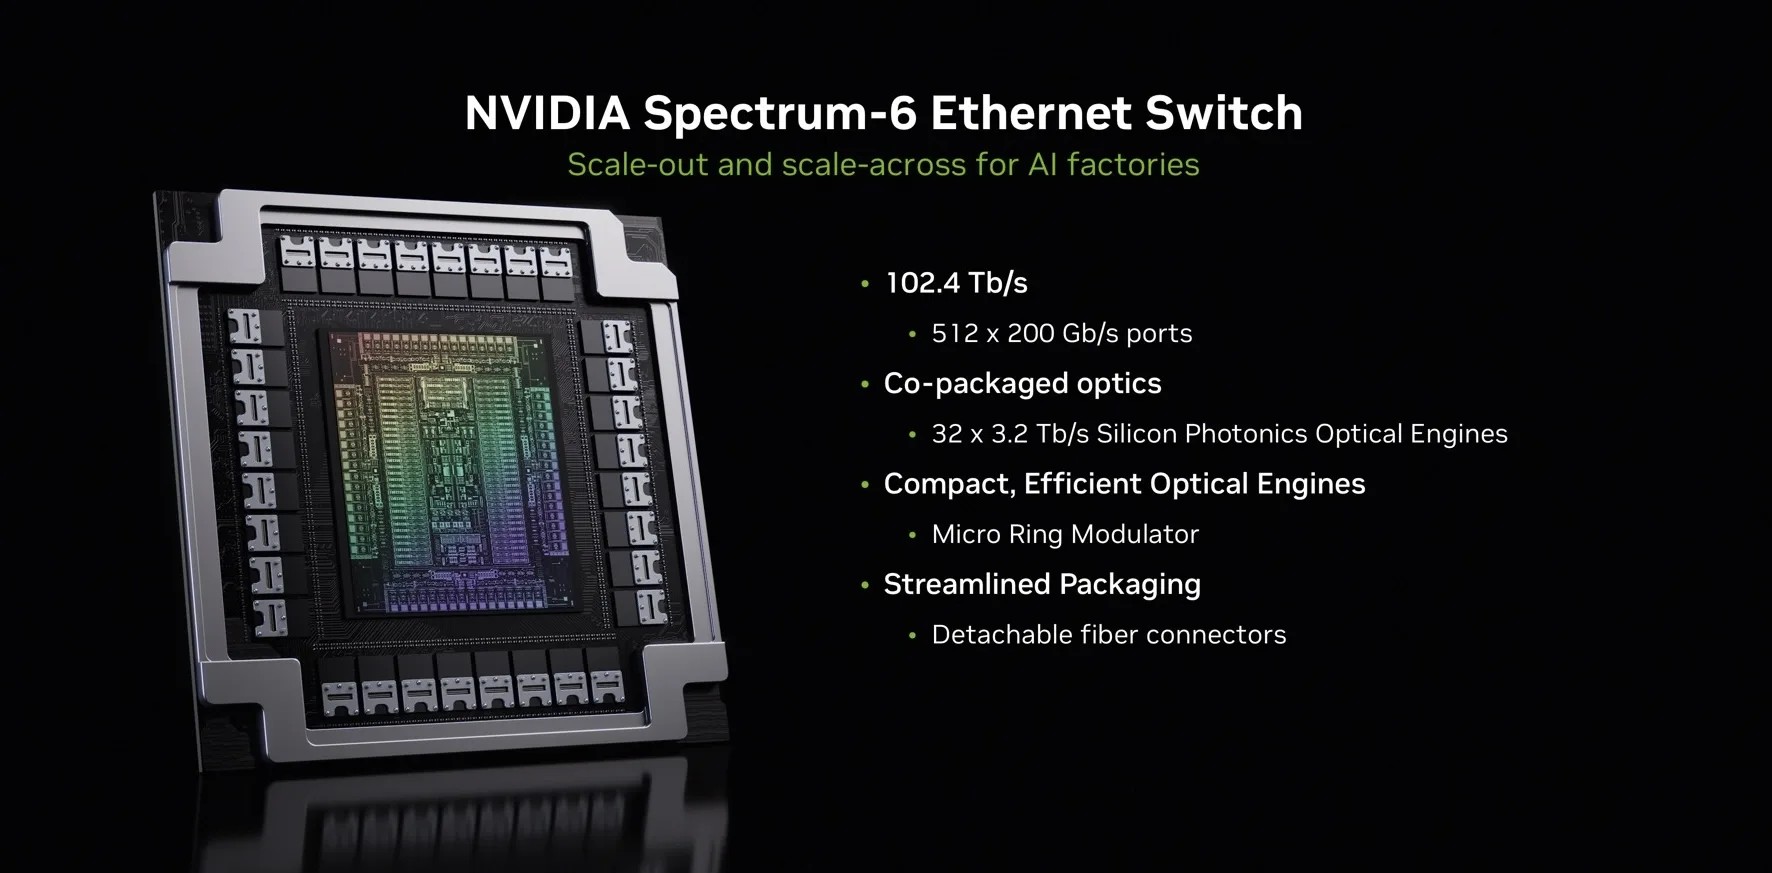
Chip mạng quang NVIDIA Spectrum-6 Ethernet và bộ tăng tốc suy luận NVIDIA Groq 3 LPU: Ở tầng kết nối liên cụm, chip chuyển mạch Spectrum-6 nhân đôi băng thông lên mức 102,4 Tb/s với 512 làn truyền dẫn 200G PAM4 SerDes, ứng dụng công nghệ quang học đóng gói đồng bộ Co-Packaged Optics (CPO) trong dòng Spectrum-X Ethernet Photonics để loại bỏ các module thu phát cắm rời, qua đó cải thiện hiệu suất năng lượng mạng gấp 5 lần và tăng độ toàn vẹn tín hiệu lên tới 64 lần. Hoàn thiện hệ sinh thái bảy vi xử lý là dòng chip tăng tốc chuyên dụng NVIDIA Groq 3 Language Processing Unit (LPU) sử dụng kiến trúc bộ nhớ thuần SRAM băng thông cực cao, được đồng thiết kế để đảm nhiệm các pha suy luận đòi hỏi độ trễ siêu thấp trên những mô hình quy mô nghìn tỷ tham số.
Sức Mạnh Hiệu Năng và Bảng Thông Số Kỹ Thuật Cốt Lõi Của Các Hệ Thống Trong Vera Rubin POD
Sự phối hợp đồng bộ giữa bảy dòng vi xử lý và năm hệ thống tủ rack chuyên biệt tạo nên bước nhảy vọt toàn diện về năng lực tính toán, băng thông truyền tải và hiệu quả năng lượng trên toàn cụm NVIDIA Vera Rubin POD. Từ cấp độ tủ rack vận hành thực tế đến từng vi mạch cấu thành, mọi chỉ số hiệu năng đều được tối ưu hóa để nâng cao thông lượng xử lý mô hình lớn và cắt giảm chi phí trên mỗi token so với các thế hệ kiến trúc trước:
Hiệu năng thực tế của từng hệ thống tủ rack trong POD: Tủ rack NVIDIA Vera Rubin NVL72 mang lại hiệu năng huấn luyện cao hơn tới 4 lần, hiệu năng suy luận trên mỗi watt cao hơn tới 10 lần và giảm chi phí token xuống còn 1/10 so với kiến trúc Blackwell, đồng thời tăng gấp 2 lần thông lượng giao tiếp all-to-all cho mô hình MoE và cắt giảm tới 50% lưu lượng all-reduce nhờ tính toán trong mạng SHARP. Khi ghép cặp cùng tủ rack NVIDIA Groq 3 LPX, tổ hợp này tạo ra lượng token cao hơn tới 35 lần và mở rộng cơ hội doanh thu gấp 10 lần cho các mô hình nghìn tỷ tham số so với Blackwell. Song song đó, mỗi tủ NVIDIA Vera CPU Rack duy trì đồng thời hơn 22.500 môi trường học tăng cường hoặc hộp cát tác tử với tốc độ nhanh hơn 50% và hiệu suất năng lượng gấp đôi so với CPU dạng rack truyền thống. Ở lớp dữ liệu và kết nối, tủ lưu trữ BlueField-4 STX tăng số token mỗi giây lên tới 5 lần và hiệu suất năng lượng gấp 5 lần nhờ chuyển tải KV Cache qua tầng ICMS, trong khi mạng quang Spectrum-X Ethernet Photonics của tủ Spectrum-6 SPX cải thiện hiệu suất điện năng mạng gấp 5 lần và nâng cao độ toàn vẹn tín hiệu gấp 64 lần nhờ giảm suy hao quang từ khoảng 22 dB xuống còn 4 dB.
Bảng so sánh thông số vi xử lý NVIDIA Grace CPU và NVIDIA Vera CPU
| Thông số kỹ thuật | NVIDIA Grace CPU | NVIDIA Vera CPU |
| Số nhân xử lý | 72 nhân Neoverse V2 | 88 nhân tùy biến NVIDIA Olympus |
| Số luồng xử lý | 72 luồng | 176 luồng Spatial Multithreading |
| Bộ nhớ đệm L2 mỗi nhân | 1 MB | 2 MB |
| Bộ nhớ đệm L3 hợp nhất | 114 MB | 164 MB |
| Băng thông bộ nhớ | Tối đa 512 GB/s | Tối đa 1,2 TB/s |
| Dung lượng bộ nhớ | Tối đa 480 GB LPDDR5X | Tối đa 1,5 TB LPDDR5X |
| Tập lệnh SIMD | 4x 128b SVE2 | 6x 128b SVE2 FP8 |
| Băng thông NVLink-C2C | 900 GB/s | 1,8 TB/s |
| Giao tiếp PCIe / CXL | Gen5 | Gen6 / CXL 3.1 |
| Điện toán bảo mật Confidential Compute | Không hỗ trợ | Hỗ trợ đầy đủ |
Bảng so sánh năng lực tính toán AI và băng thông kết nối giữa NVIDIA Blackwell và NVIDIA Rubin GPU
| Thông số kỹ thuật | NVIDIA Blackwell GPU | NVIDIA Rubin GPU |
| Số lượng bóng bán dẫn toàn chip | 208 tỷ | 336 tỷ |
| Số đế tính toán | 2 | 2 |
| Hiệu năng suy luận NVFP4 | 10 PFLOPS | 50 PFLOPS (qua Transformer Engine) |
| Hiệu năng huấn luyện NVFP4 | 10 PFLOPS | 35 PFLOPS (tính toán dày đặc) |
| Tăng tốc Softmax (SFU EX2 Ops/Clk/SM cho FP32 | FP16) | 16 | 32 | 64 |
| Băng thông NVLink GPU-tới-GPU hai chiều | 1.800 GB/s | 3.600 GB/s |
| Băng thông NVLink-C2C CPU-tới-GPU hai chiều | 900 GB/s | 1.800 GB/s |
| Băng thông giao tiếp PCIe hai chiều | 256 GB/s chuẩn Gen 6 | 256 GB/s chuẩn Gen 6 |
Bảng so sánh năng lực tính toán khoa học FP32 và FP64 giữa các thế hệ GPU NVIDIA
| Thông số kỹ thuật | NVIDIA Hopper GPU | NVIDIA Blackwell GPU | NVIDIA Rubin GPU |
| FP32 vector | 67 TFLOPS | 80 TFLOPS | 130 TFLOPS |
| FP32 ma trận | 67 TFLOPS | 227 TFLOPS* | 400 TFLOPS* |
| FP64 vector | 34 TFLOPS | 40 TFLOPS | 33 TFLOPS |
| FP64 ma trận | 67 TFLOPS | 150 TFLOPS* | 200 TFLOPS* |
*Hiệu năng đỉnh đạt được thông qua thuật toán mô phỏng dựa trên nhân Tensor Core.
Bảng so sánh thông số bộ xử lý dữ liệu NVIDIA BlueField-3 và NVIDIA BlueField-4 DPU
| Thông số kỹ thuật | NVIDIA BlueField-3 DPU | NVIDIA BlueField-4 DPU |
| Băng thông mạng | 400 Gb/s | 800 Gb/s |
| Năng lực tính toán | 16 nhân Arm A78 | 64 nhân Arm Neoverse V2 (hiệu năng gấp 6 lần) |
| Băng thông bộ nhớ | 75 GB/s | 250 GB/s |
| Dung lượng bộ nhớ | 32 GB | 128 GB |
| Quy mô mạng đám mây | 32.000 máy chủ | 128.000 máy chủ |
| Mã hóa dữ liệu truyền tải | 400 Gb/s | 800 Gb/s |
| Phân tách lưu trữ NVMe | 10 triệu IOPS ở khối 4K | 20 triệu IOPS ở khối 4K |
Bảng so sánh thế hệ hạ tầng mạng mở rộng NVIDIA Spectrum-X Ethernet
| Thông số kỹ thuật | Nền tảng Grace Blackwell | Nền tảng Vera Rubin |
| Thành phần cốt lõi | Dòng Spectrum-X SN5000 và ConnectX-8 SuperNIC | Dòng Spectrum-X SN6000 và ConnectX-9 SuperNIC |
| Vi xử lý | Spectrum-4 và ConnectX-8 | Spectrum-6 và ConnectX-9 |
| Băng thông tối đa | 51,2 Tb/s mỗi chip switch (64 x 800 Gb/s) và 800 Gb/s (2 x 400G) mỗi GPU | 102,4 Tb/s mỗi chip switch (128 x 800 Gb/s) và 1.600 Gb/s (2 x 800 Gb/s) mỗi GPU |
| Tốc độ truyền dẫn SerDes | 100G PAM4 trên switch; 100/200G PAM4 trên SuperNIC | 200G PAM4 trên cả switch và SuperNIC |
| Giao thức hỗ trợ | Ethernet trên switch; Ethernet và InfiniBand trên SuperNIC | Ethernet trên switch; Ethernet và InfiniBand trên SuperNIC |
| Chuẩn kết nối vật lý | OSFP trên switch; OSFP và QSFP112 trên SuperNIC | OSFP trên switch; OSFP và QSFP112 trên SuperNIC |
Sự ra đời của NVIDIA Vera Rubin POD đánh dấu bước chuyển dịch toàn diện trong kiến trúc hạ tầng trí tuệ nhân tạo, nơi bảy dòng vi xử lý chuyên dụng cùng năm hệ thống tủ rack đặc thù được đồng thiết kế để vận hành như một siêu máy tính AI thống nhất. Bằng cách kết hợp năng lực tính toán mật độ cao của Vera Rubin NVL72, khả năng suy luận độ trễ siêu thấp của Groq 3 LPX, hạ tầng hộp cát quy mô lớn trên Vera CPU Rack, tầng bộ nhớ ngữ cảnh dùng chung BlueField-4 STX cùng mạng quang đồng bộ Spectrum-6 SPX, nền tảng giải quyết triệt để mọi nút thắt của kỷ nguyên tác tử tự hành. Đi kèm khối triển khai tiêu chuẩn NVIDIA DGX SuperPOD, hệ sinh thái phần mềm tương thích ngược hoàn toàn với CUDA và lộ trình mở rộng sẵn sàng cho thế hệ Vera Rubin Ultra lẫn NVIDIA Kyber, giải pháp mang lại hiệu suất trên mỗi watt vượt trội, cắt giảm đáng kể chi phí trên mỗi token và tạo bệ phóng vững chắc để doanh nghiệp làm chủ các nhà máy AI quy mô lớn.
Hiệu quả của một nhà máy AI trong kỷ nguyên tác tử tự hành không nằm ở việc tích lũy từng linh kiện đơn lẻ mạnh đến đâu, mà ở sự đồng bộ trọn vẹn giữa năng lực tính toán, bộ nhớ ngữ cảnh dài và mạng kết nối tốc độ cao.
-
Doanh nghiệp của bạn có đang tìm kiếm một kiến trúc hạ tầng AI đồng bộ để giải quyết đồng thời bài toán huấn luyện mô hình lớn, suy luận ngữ cảnh dài độ trễ thấp và tối ưu chi phí vận hành trên mỗi token?
-
Đội ngũ kỹ thuật của đơn vị bạn đang cần tư vấn quy hoạch cụm máy chủ GPU và CPU chuyên biệt theo tiêu chuẩn của NVIDIA nhằm đảm bảo khả năng mở rộng linh hoạt cho các thế hệ phần cứng tương lai?
Hãy liên hệ ngay với đội ngũ chuyên gia hạ tầng tại Nhất Tiến Chung để được tư vấn chuyên sâu, định cỡ kiến trúc hệ thống và đồng hành triển khai giải pháp hạ tầng AI NVIDIA tối ưu nhất cho doanh nghiệp của bạn.