NVIDIA DGX Spark HPC Developer Kit: Biến Bàn Làm Việc Thành Phòng Thí Nghiệm Siêu Tính Toán
Trong lĩnh vực nghiên cứu khoa học, học thuật và phát triển công nghệ hiện đại, nhu cầu vận hành các bài toán mô phỏng đa nodes, huấn luyện mô hình trí tuệ nhân tạo (AI) và triển khai tác tử tự hành (AI Agents) đang tăng trưởng với tốc độ nhanh chóng. Tuy nhiên, phần lớn các nhóm nghiên cứu và phát triển (R&D) hiện nay vẫn phải phụ thuộc vào các cụm máy chủ GPU dùng chung với hạn ngạch tính toán cố định. Việc xếp hàng chờ cấp phát tài nguyên cho từng tác vụ không chỉ làm gián đoạn mạch tư duy thử nghiệm, mà còn tiêu tốn nhiều giờ vận hành máy chủ đắt đỏ vào các công đoạn phát triển và gỡ lỗi sơ bộ. Bên cạnh đó, yêu cầu đưa dữ liệu lên hạ tầng tập trung cũng đặt ra bài toán khắt khe về bảo mật đối với các tập dữ liệu độc quyền và những kết quả nghiên cứu chưa công bố.
Nhằm tháo gỡ triệt để nút thắt hạ tầng này, tại hội nghị siêu tính toán thường niên SC26 diễn ra ở Chicago, NVIDIA đã chính thức giới thiệu bộ công cụ NVIDIA DGX Spark HPC Developer Kit dành riêng cho các nhà nghiên cứu, giới học thuật và lập trình viên. Giải pháp đưa sức mạnh của siêu chip GB10 Grace Blackwell Superchip trực tiếp lên bàn làm việc thông qua kiến trúc cụm 4 nodes NVIDIA DGX Spark liên kết trực tiếp với nhau. Thay vì phải chờ đợi trên các hệ thống siêu máy tính dùng chung, các nhóm kỹ thuật giờ đây có thể tự chủ hoàn toàn quy trình phát triển, kiểm thử và vận hành các khối lượng công việc Điện toán Hiệu năng cao (High Performance Computing – HPC) đa nodes ngay tại chỗ, giữ trọn vẹn dữ liệu nhạy cảm trong phạm vi kiểm soát nội bộ trước khi mở rộng quy mô lên các hệ thống tính toán lớn hơn.
Kiến trúc Cụm 4 Nodes Không Cần Switch và Năng lực Vận hành Mô hình 700 Tỷ Tham số
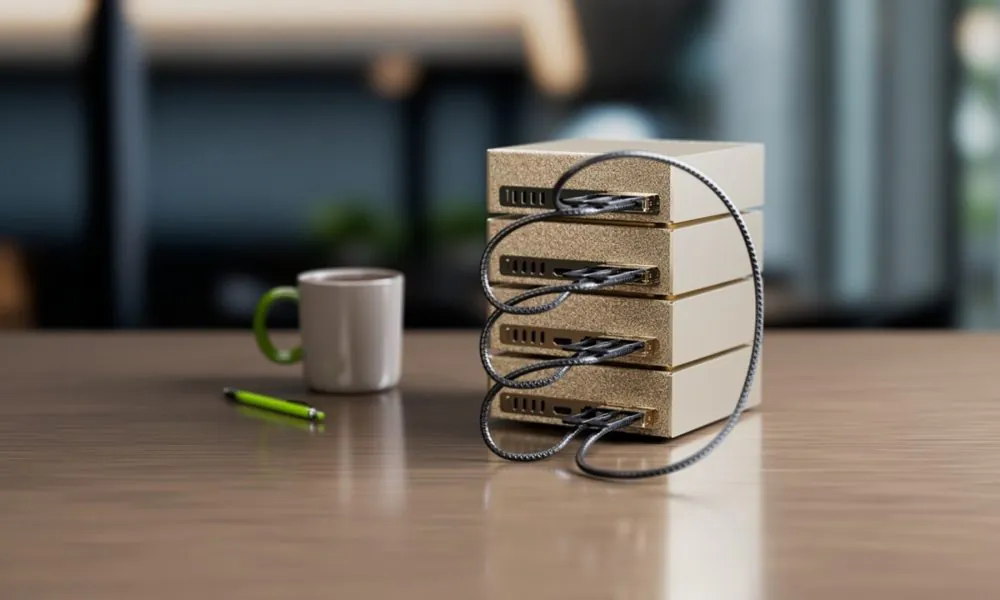
Để biến một không gian làm việc tiêu chuẩn thành môi trường tính toán đa nodes thực thụ mà không đòi hỏi hạ tầng phòng máy phức tạp, NVIDIA đã tối ưu hóa toàn diện kiến trúc kết nối và phân bổ tài nguyên trên DGX Spark HPC Developer Kit:
-
Mở rộng linh hoạt từ 1 đến 4 nodes theo cấu trúc vòng không cần switch: Hệ thống cho phép mở rộng quy mô từ một nodes đơn lẻ lên cụm 4 nodes tính toán, trong đó mỗi thiết bị NVIDIA DGX Spark được kết nối trực tiếp với hai nodes lân cận theo cấu trúc vòng (Ring Topology) thông qua giao tiếp mạng tốc độ cao NVIDIA ConnectX-7. Kiến trúc liên kết trực tiếp này loại bỏ hoàn toàn nhu cầu đầu tư, đi dây và cấu hình thiết bị chuyển mạch mạng (Switch), giúp các nhóm kỹ thuật nhanh chóng đưa cụm tính toán vào vận hành ngay tại chỗ.
-
Tài nguyên bộ nhớ 512GB và lưu trữ NVMe 20TB hợp nhất: Khi triển khai ở cấu hình đầy đủ 4 nodes, cụm hệ thống cung cấp tổng dung lượng bộ nhớ hợp nhất lên tới 512GB cùng 20TB không gian lưu trữ NVMe tốc độ cao. Nền tảng phần cứng dồi dào này tạo không gian rộng mở để các nhà nghiên cứu phân bổ các mô hình quy mô lớn và những khối lượng công việc khoa học chuyên sâu xuyên suốt toàn bộ cụm.
- Triển khai cục bộ mô hình 700 tỷ tham số với chuẩn NVFP4: Nhờ sự kết hợp giữa băng thông liên kết nội cụm tốc độ cao và công nghệ lượng tử hóa NVFP4, các nhóm nghiên cứu có thể triển khai cục bộ những mô hình lên tới 700 tỷ tham số trên cụm 4 nodes DGX Spark, tiêu biểu như DeepSeek V4.1.
-
Tự chủ phát triển, gỡ lỗi và bảo mật dữ liệu tại chỗ: Việc sở hữu năng lực tính toán mạnh mẽ ngay trên bàn làm việc giúp các nhà nghiên cứu có hạn ngạch máy chủ cố định không còn phải xếp hàng chờ đợi cho mọi tác vụ. Đội ngũ kỹ thuật có thể chủ động phát triển và gỡ lỗi độc lập tại chỗ, dành trọn thời gian trên các cụm máy chủ tập trung cho những phiên chạy thực tế quy mô lớn, đồng thời lưu giữ an toàn các tập dữ liệu độc quyền và kết quả nghiên cứu chưa công bố ngay trong phạm vi kiểm soát của tổ chức.
| Chỉ số hiệu năng | 1 DGX Spark node TP1 (ms) | 2 DGX Spark nodes TP2 (ms) | 4 DGX Spark nodes TP4 (ms) |
| TTFT (càng thấp càng tốt) | 33,415 | 21,384 | 15,552 |
| TPOT (càng thấp càng tốt) | 269 | 133 | 72 |
Bảng 1: Khả năng mở rộng hiệu năng mô hình Llama 3.3 70B Instruct chuẩn NVFP4 trên TensorRT LLM với 1, 2 và 4 nodes DGX Spark (độ dài đầu vào 32K, đầu ra 1K, kích thước lô batch size bằng 1)
| Chỉ số hiệu năng | 1 DGX Spark node TP1 | 2 DGX Spark nodes TP2 | 4 DGX Spark nodes TP4 |
| Collection time | 12.1 s | 11.4 s | 10.4 s |
| Learning time | 40.9 s | 41.4 s | 42.3 s |
| # environments | 1,024 | 1,024 | 1,024 |
| FPS | 630 | 1,241 | 2,520 |
Bảng 2: Khả năng mở rộng hiệu năng học tăng cường trên nền tảng Isaac Lab với 1, 2 và 4 nodes DGX Spark
| HW configuration | Total token throughput (tok/s) | Speedup versus 1 DGX Spark node |
| 1 DGX Spark node | ~18,400 | 1 |
| 2 DGX Spark nodes | ~35,900 | 2 |
| 4 DGX Spark nodes | ~74,600 | 4 |
Bảng 3: Khả năng mở rộng hiệu năng tinh chỉnh mô hình Nanochat từ 1 đến 4 nodes DGX Spark
| Nodes | Samples/step | Batch size | Samples/s | Speedup |
| 1 DGX Spark node | 15.73 | 32 | 2.03 | – |
| 3 DGX Spark nodes | 15.69 | 96 | 6.12 | 3x |
Bảng 4: Khả năng mở rộng từ 1 lên 3 nodes DGX Spark, mỗi node vận hành toàn bộ mô hình Qwen3 4B (kích thước lô batch size 4 mẫu trên mỗi thiết bị, chuẩn BF16)
Hệ sinh thái Phần mềm Siêu tính toán NVIDIA HPC SDK và Chuỗi Công cụ Mô phỏng Khoa học
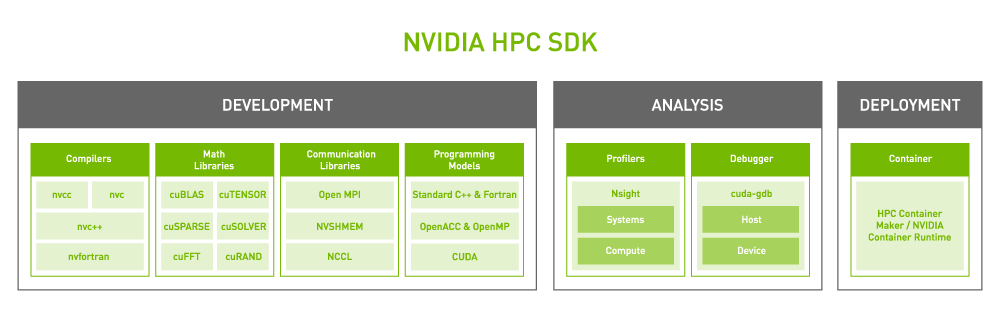
Sức mạnh phần cứng của cụm 4 nodes chỉ thực sự phát huy trọn vẹn giá trị khi đi kèm một môi trường phần mềm đồng nhất với các trung tâm siêu tính toán quy mô lớn. Trên NVIDIA DGX Spark HPC Developer Kit, toàn bộ chuỗi công cụ biên dịch, thư viện khoa học và nền tảng phát triển AI được chuẩn hóa nhằm rút ngắn tối đa khoảng cách từ khâu thử nghiệm tại bàn làm việc đến vận hành thực tế:
-
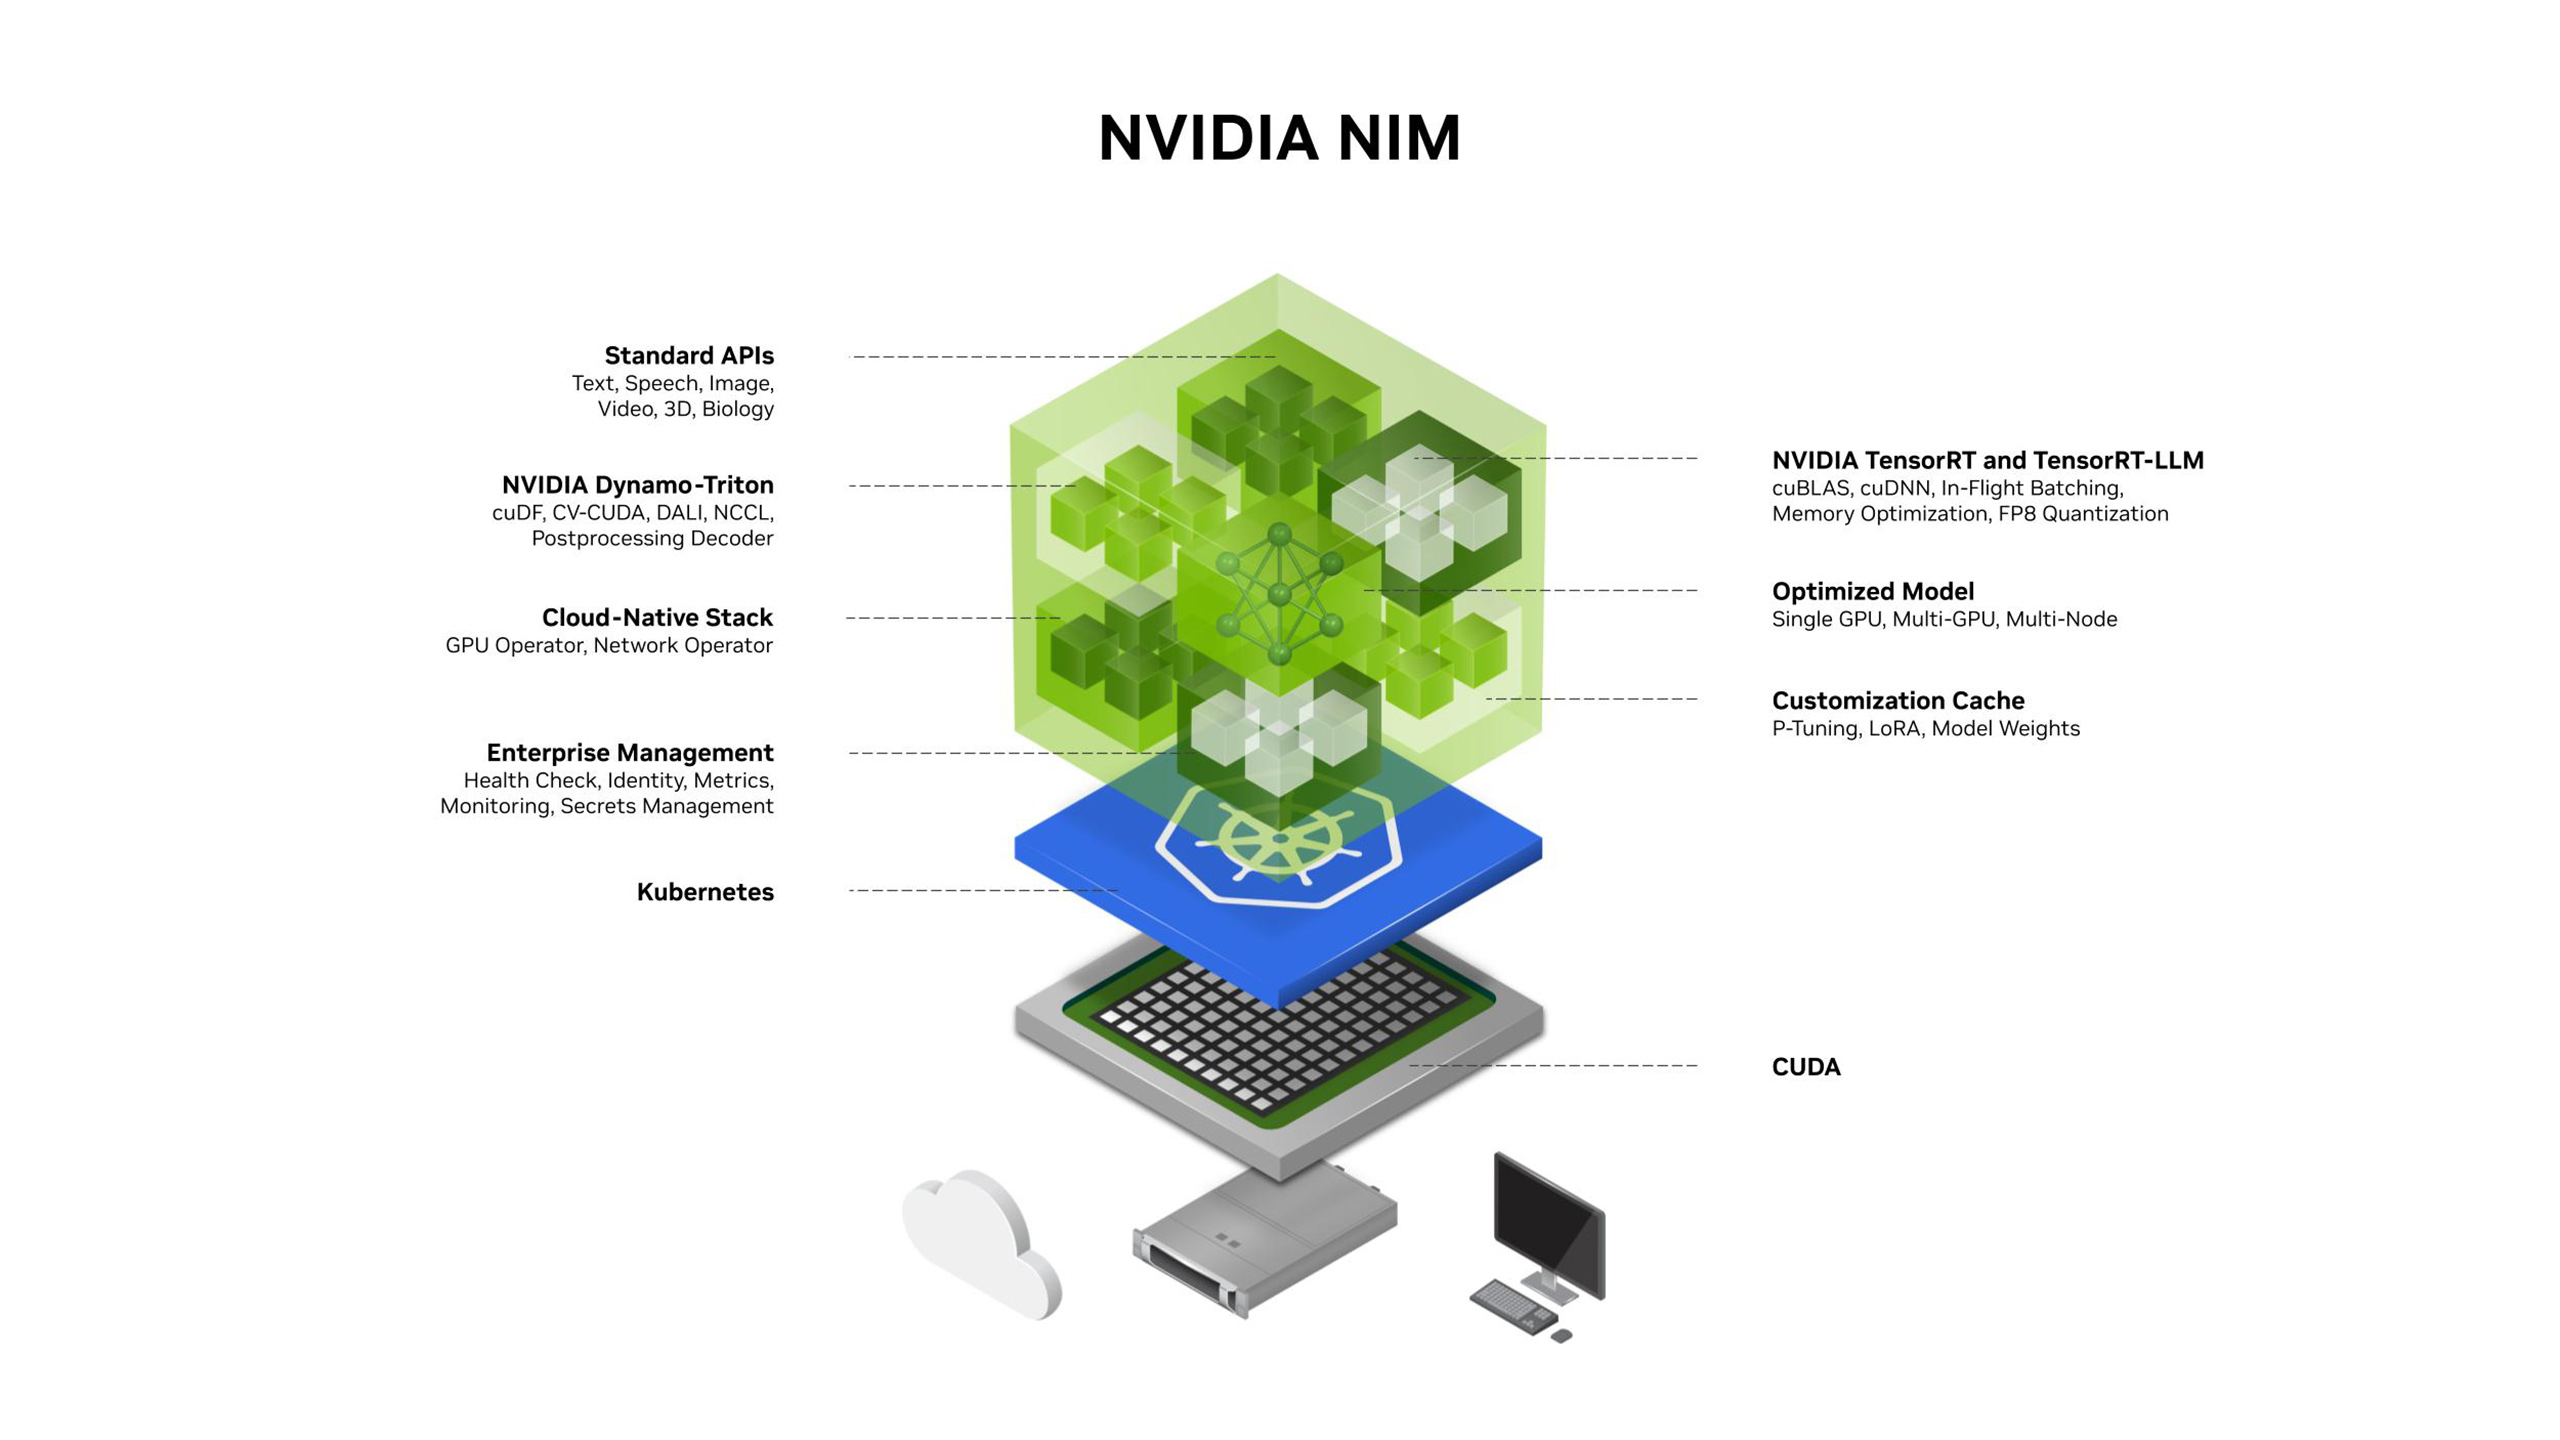
Kịch bản triển khai NVIDIA HPC SDK chuẩn siêu máy tính: Gói kịch bản cài đặt dành cho NVIDIA HPC SDK đang chuẩn bị ra mắt sẽ mang đến đầy đủ các trình biên dịch C, C++ và Fortran tăng tốc GPU, các bộ thư viện chuyên dụng cùng công cụ giao diện truyền thông điệp MPI (Message Passing Interface) trực tiếp lên cụm DGX Spark. Đây là hệ thống công cụ phát triển tiêu chuẩn đang vận hành trên các siêu máy tính sử dụng nền tảng NVIDIA, cho phép các nhóm kỹ thuật xây dựng và kiểm thử ứng dụng khoa học xuyên suốt 4 nodes, kiểm tra cách thức phân bổ dữ liệu và tác vụ tính toán, đồng thời gỡ lỗi các vấn đề giao tiếp nội cụm trước khi mở rộng sang những hệ thống quy mô lớn hơn.
-
Vận hành đa dạng tải công việc mô phỏng khoa học và vi dịch vụ NIM: Bộ công cụ đưa năng lực mô phỏng khoa học chuyên sâu cùng các mô hình và tác tử AI trực tiếp lên bàn làm việc, với các bài toán 4 hệ thống đã được trình diễn thực tế bao gồm LAMMPS tích hợp Kokkos cho mô phỏng vật liệu và NAMD cho động lực học phân tử. Bên cạnh đó, cộng đồng phát triển DGX Spark cũng đã kiểm chứng khả năng vận hành ổn định của nhiều nền tảng chuyên ngành như GROMACS trong động lực học phân tử, OpenFOAM trong động lực học chất lưu, WRF cho mô hình dự báo thời tiết, cùng các vi dịch vụ NVIDIA NIM như OpenFold3 và Boltz-2 phục vụ dự đoán cấu trúc phân tử sinh học.
-
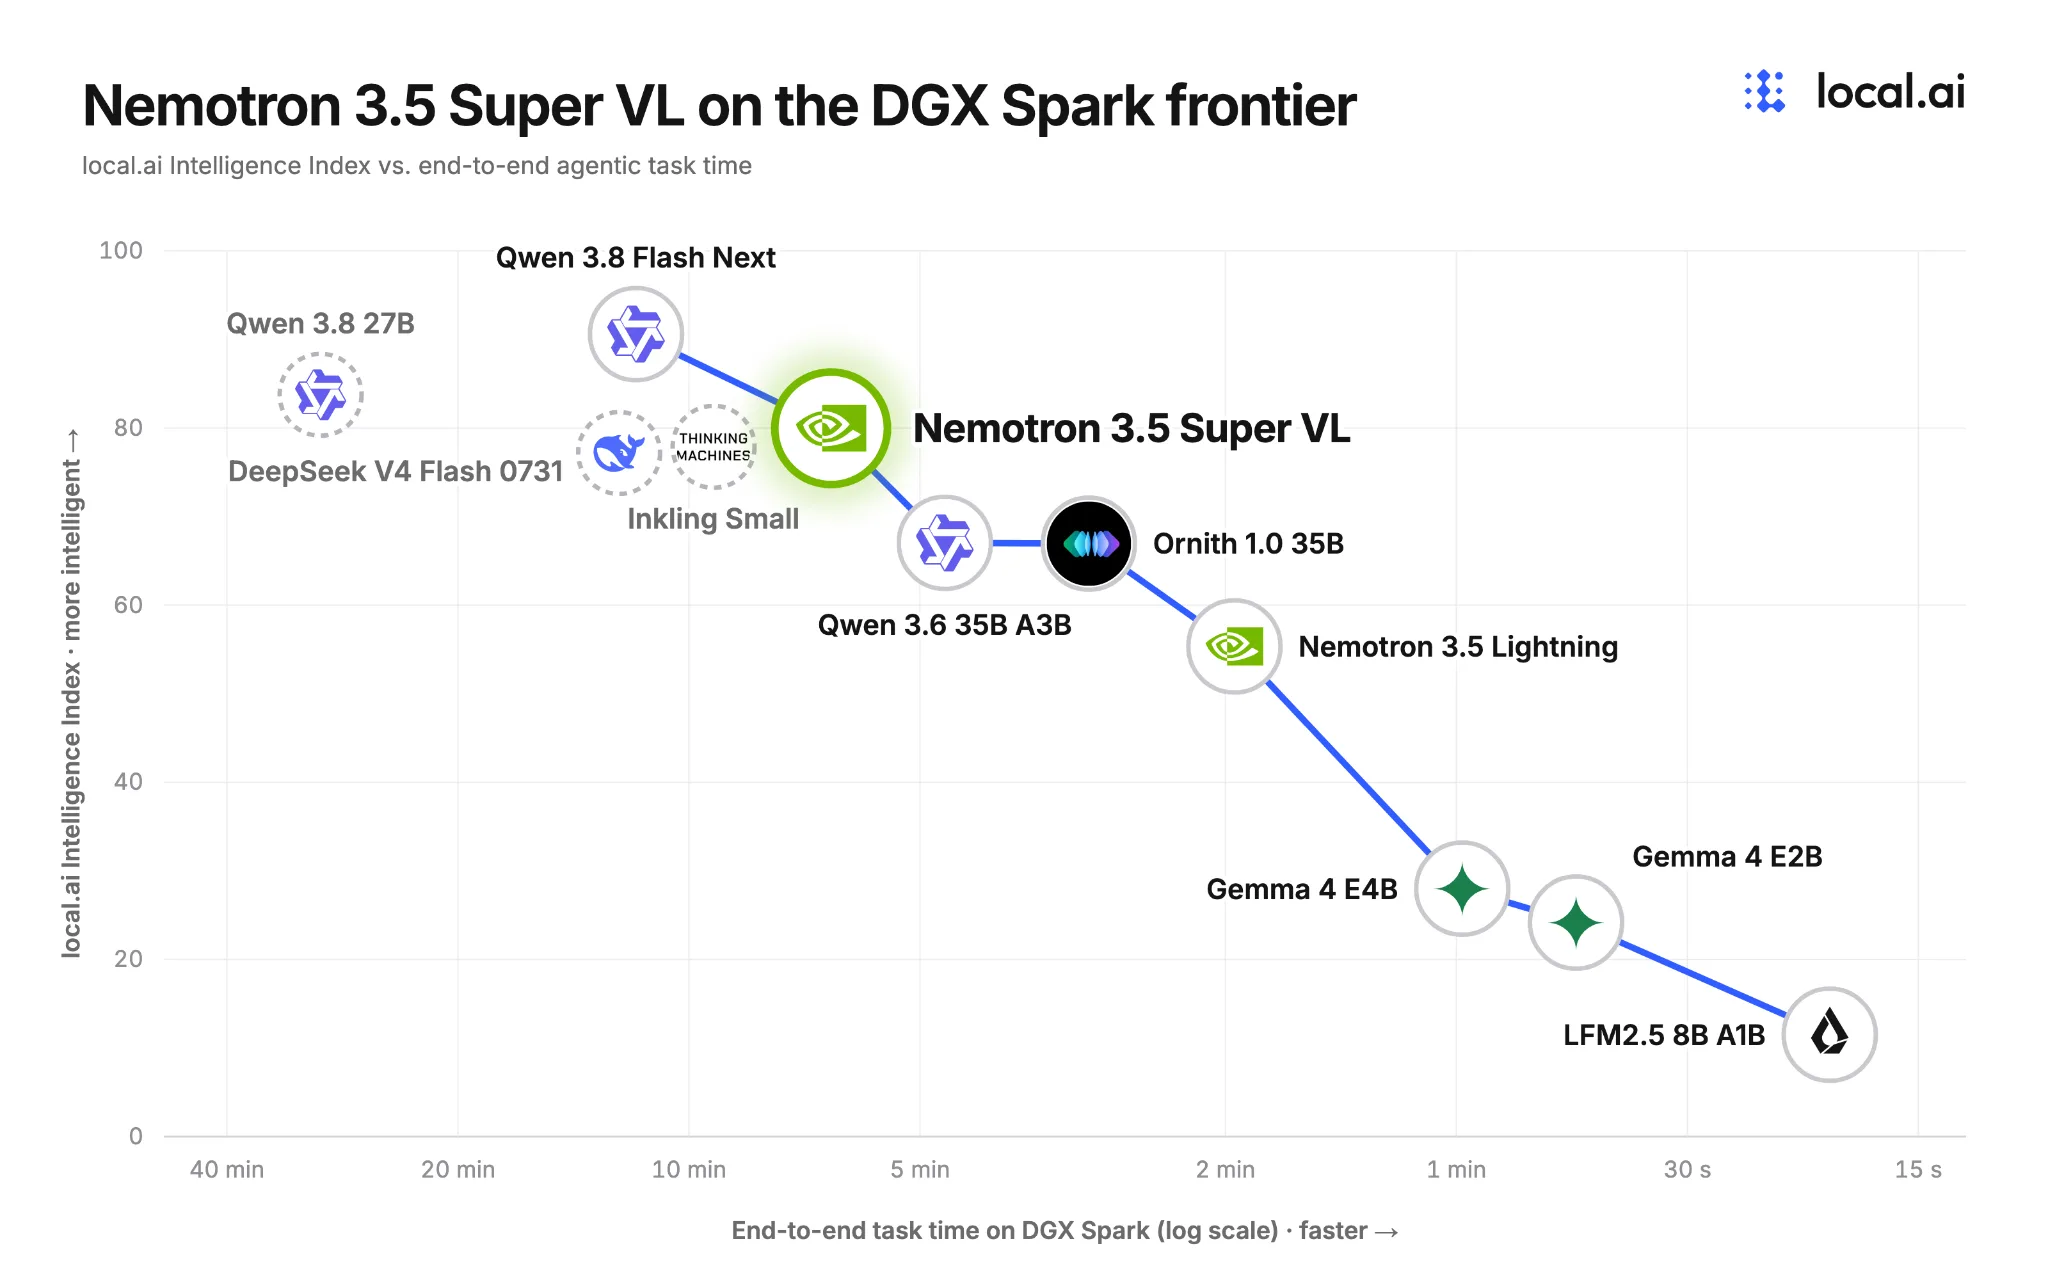
Tùy biến mô hình Nemotron 3.5 Super VL cho khoa học sự sống và hóa học: Khi vận hành trên nền tảng DGX Spark, bộ dữ liệu mở cùng các công thức hậu huấn luyện mới dành cho mô hình Nemotron 3.5 Super VL hỗ trợ các nhà nghiên cứu tinh chỉnh mô hình chuyên biệt cho lĩnh vực khoa học sự sống và hóa học, qua đó kiến tạo các quy trình nghiên cứu khoa học an toàn ngay trên hạ tầng do tổ chức tự chủ kiểm soát.
Đột phá Quy trình Nghiên cứu AI và Các Ứng dụng Thực tế
Việc đưa năng lực siêu tính toán đa nodes về ngay bàn làm việc không chỉ rút ngắn thời gian chờ đợi hạ tầng, mà còn mở ra những phương thức tiếp cận hoàn toàn mới trong nghiên cứu khoa học và phát triển AI. Nhiều tổ chức và phòng thí nghiệm hàng đầu đã ứng dụng NVIDIA DGX Spark để giải quyết các bài toán chuyên sâu với hiệu quả vượt trội:
-
Quy trình nghiên cứu tích hợp tác tử AI và mô hình mô phỏng thay thế: Các nhà khoa học có thể triển khai quy trình làm việc có sự hỗ trợ của AI Agent để tự động chuẩn bị dữ liệu đầu vào mô phỏng, khởi chạy các phiên tính toán và tổng hợp kết quả, trong khi đội ngũ chuyên gia tập trung thẩm định thiết lập và kết luận. Bên cạnh đó, hệ thống cho phép huấn luyện các mô hình AI xấp xỉ những phép mô phỏng truyền thống vốn tốn nhiều thời gian, qua đó tinh chỉnh thiết kế cánh máy bay nhằm đạt mức lực cản tối thiểu, hoặc thu hẹp bài toán mô phỏng 10 triệu phần tử xuống còn 50 đến 500 chiều dữ liệu trọng yếu trước khi phân bổ tài nguyên trên siêu máy tính.
-
Kvantify ứng dụng NVIDIA cuQuantum trong mô phỏng hóa học lượng tử: Đơn vị này khai thác thư viện NVIDIA cuQuantum để vận hành các phép mô phỏng mạng tensor cho mạch hóa học lượng tử với quy mô lên tới 70 qubit và 975 cổng lượng tử trên một thiết bị DGX Spark duy nhất, phục vụ đo kiểm các mạch tính toán năng lượng trạng thái cơ bản của phân tử penicillin.
-
CYRAN AI tăng tốc phân tích dữ liệu không gian địa lý tại chỗ: Doanh nghiệp tách ra từ Viện Công nghệ Ấn Độ Delhi (IIT Delhi) kết hợp DGX Spark cùng thư viện PixelFlux nhằm tăng tốc quá trình giải mã ảnh vệ tinh định dạng JPEG 2000 dung lượng lớn, hỗ trợ trực tiếp cho các tác vụ phân tích không gian địa lý cục bộ.
-
OpenFold nâng cao độ chính xác dự đoán cấu trúc phân tử sinh học: Nhóm nghiên cứu chứng minh khả năng tinh chỉnh mô hình OpenFold3 ngay trên NVIDIA DGX Spark nhằm cải thiện độ chính xác trong việc dự đoán cấu trúc tương tác giữa protein và phối tử, thúc đẩy tiến độ phát triển dược phẩm.
-
Phòng thí nghiệm Rubin Lab rút ngắn thời gian phân tích hệ gen nhanh hơn 15 lần: Trực thuộc Viện Hệ gen Sáng tạo IGI tại Đại học California ở Berkeley (UC Berkeley), phòng thí nghiệm sử dụng DGX Spark kết hợp mô hình NVIDIA Evo 2 để dự đoán trực tiếp đặc tính của vi khuẩn từ trình tự hệ gen thông qua việc đối chiếu các biểu diễn nhúng từ mô hình ngôn ngữ hệ gen và protein với các phương pháp chuẩn truyền thống. Nhờ loại bỏ hoàn toàn 11 giờ xếp hàng chờ đợi trên cụm máy chủ dùng chung, kết quả nghiên cứu trên DGX Spark thu được nhanh hơn 15 lần.
-
Nhóm nghiên cứu Hartwig Group huấn luyện liên tục mô hình 120 tỷ tham số trên một thiết bị: Cũng tại UC Berkeley, nhóm sử dụng DGX Spark để thực hiện tinh chỉnh LoRA trên mô hình Nemotron 3 Super 120B-A12B phục vụ học máy trong hóa học, huấn luyện tầng dự đoán dựa trên các giá trị thực nghiệm. Nhờ vận hành cục bộ bằng công nghệ lượng tử hóa NVFP4, phòng thí nghiệm đã đưa thành công mô hình cấp độ 120 tỷ tham số lên một thiết bị đơn lẻ, loại bỏ thời gian chờ đợi kéo dài nhiều ngày trên cụm tập trung để chạy liên tiếp các phiên huấn luyện từ 8 đến 24 giờ.
Sự ra đời của NVIDIA DGX Spark HPC Developer Kit đánh dấu bước chuyển dịch quan trọng trong cách thức tổ chức và vận hành hạ tầng nghiên cứu khoa học lẫn phát triển AI hiện đại. Bằng việc kết hợp siêu chip GB10 Grace Blackwell Superchip, kiến trúc cụm 4 nodes liên kết trực tiếp qua NVIDIA ConnectX-7 không cần thiết bị chuyển mạch, tài nguyên hợp nhất 512GB bộ nhớ cùng 20TB lưu trữ NVMe và hệ sinh thái phần mềm chuẩn siêu máy tính NVIDIA HPC SDK, giải pháp mang lại năng lực xử lý các mô hình lên tới 700 tỷ tham số cùng các bài toán mô phỏng đa nodes phức tạp ngay trên bàn làm việc. Nhờ đó, các viện nghiên cứu và đội ngũ R&D có thể loại bỏ hoàn toàn thời gian chờ đợi trên các cụm GPU tập trung, bảo toàn tuyệt đối dữ liệu độc quyền tại chỗ và rút ngắn đáng kể chu kỳ thử nghiệm trước khi mở rộng lên hạ tầng quy mô lớn.
Tốc độ đổi mới trong nghiên cứu khoa học và phát triển AI không nằm ở việc sở hữu hạn ngạch trên những siêu máy tính xa vời, mà ở khả năng chủ động thử nghiệm, gỡ lỗi và lặp lại mô hình liên tục ngay tại bàn làm việc của từng kỹ sư.
-
Đội ngũ R&D của đơn vị bạn có đang bị kìm hãm tiến độ do thời gian xếp hàng chờ cấp phát tài nguyên trên cụm GPU dùng chung hoặc lo ngại rủi ro bảo mật khi đưa dữ liệu nghiên cứu nhạy cảm lên hạ tầng tập trung?
-
Bạn đang tìm kiếm một kiến trúc cụm tính toán đa nodes gọn nhẹ, đồng nhất công cụ phát triển chuẩn HPC để chạy thử nghiệm mô phỏng khoa học và triển khai cục bộ các mô hình AI hàng trăm tỷ tham số?
Hãy liên hệ ngay với đội ngũ chuyên gia hạ tầng tại Nhất Tiến Chung để được tư vấn chuyên sâu về NVIDIA DGX Spark, và triển khai giải pháp siêu tính toán tại chỗ tối ưu nhất cho tổ chức của bạn.