Hợp lực cùng lúc 2 máy trạm NVIDIA GB300 thì có thể làm được gì cho Agentic AI?
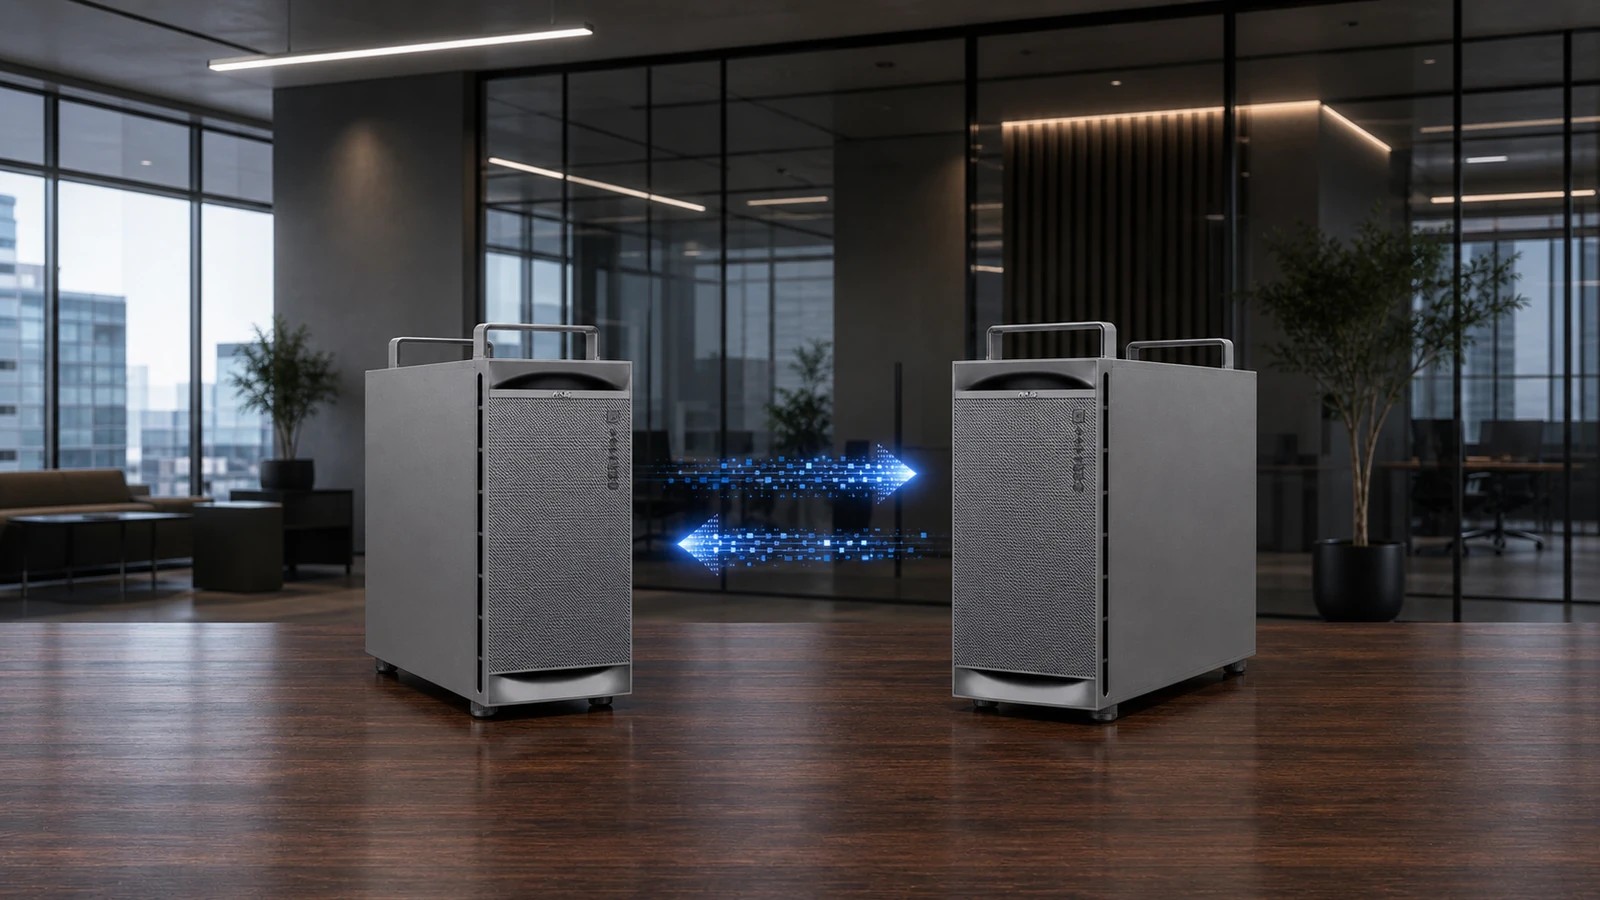
Các hệ thống Agentic AI hiếm khi chạy một mô hình duy nhất. Một pipeline điển hình kết hợp một mô hình lý luận lớn lên kế hoạch và ủy quyền với các mô hình nhỏ hơn lấy tài liệu, gọi công cụ, viết mã và kiểm tra kết quả, và tất cả đều cạnh tranh bộ nhớ GPU cùng lúc.
Một chiếc máy trạm duy nhất được xây dựng trên NVIDIA DGX Station GB300 có thể xử lý phần lớn việc đó ngay trên bàn làm việc. Nhưng với hai chiếc được ghép nối với nhau thì làm được gì?
Những gì một chiếc máy trạm dựa trên GB300 mang lại cho Agentic AI
Mỗi thiết bị được xây dựng dựa trên NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip, kết hợp một GPU Blackwell Ultra với CPU Grace 72 nhân thay vì NVLink-C2C. Theo hướng dẫn phát triển của NVIDIA, một hệ thống duy nhất cung cấp:
- 748GB bộ nhớ đồng bộ: 252GB HBM3e với tốc độ lên đến 7.1TB/s, cộng thêm 496GB LPDDR5X lên đến 396GB/s
- Phép toán FP4 rời rạc lên đến 20 petaFLOPS với NVFP4 gốc
- Tối đa bảy phân vùng MIG cách ly
- Kết hợp mạng 800Gb/s qua hai cổng ConnectX-8 400Gb/s
Những gì chúng tôi đo được: Một WorkStation với GB300 chạy 256 agent Qwen3 đồng thời với không có agent nào thất bại và tỷ lệ đạt ổn định từ 0,824–0,897. Với DeepSeek V4 Flash, vLLM báo cáo có 11,1 triệu token dung lượng bộ nhớ đệm KV—đủ cho khoảng 10,6 phiên đồng thời được cấu hình cho một triệu token mỗi phiên.
Ad
Những kết quả đó củng cố giới hạn thực tế: chỉ số lượng tác nhân không phải là nút thắt cổ chai. Kiến trúc mô hình, độ dài ngữ cảnh và nhu cầu bộ nhớ đệm KV quyết định dung lượng. Các trọng lượng vượt quá 252GB HBM3e vào LPDDR5X cũng chạy ở băng thông thấp hơn nhiều, nên việc gọi agent lặp đi lặp lại làm tăng tốc độ chậm.
Cách kết nối hai hệ thống NVIDIA DGX Station GB300
Hai hệ thống GB300 kết nối trực tiếp mà không cần switch. Sổ tay hai hệ thống của NVIDIA yêu cầu hai cáp QSFP 400G khớp với cổng 0 và cổng 1 trên mỗi máy trạm với GB300. Mỗi cáp hoạt động như một đường ray độc lập 400Gb/s chạy RoCEv2 (RDMA qua Ethernet hội tụ), di chuyển dữ liệu giữa các hệ thống với sự tham gia tối thiểu của CPU.
Không có NVLink giữa hai hệ thống. NVIDIA ước tính mất khoảng 45 đến 60 phút để khởi động core fabric, bao gồm các khung jumbo (MTU 9000) và kiểm tra RDMA GPUDirect trước khi chạy NCCL, Ray hoặc vLLM.
Một vài chi tiết thực tế cần lên kế hoạch:
- Cả hai cổng QSFP đều đi đến liên kết ngang hàng. Lưu lượng LAN và lưu trữ thông thường của mỗi thiết bị sẽ chuyển đến cổng RJ-45 10GbE của nó.
- Con số 2 là mức trần đã được ghi nhận. Tài liệu của NVIDIA mô tả việc nối cụm hai hệ thống lại với nhau và không công bố cấu hình switch cho số lượng nhiều hơn. Tuy nhiên, nếu bạn có switch mạng, việc kết nối nhiều máy trạm với GB300 là khả thi.
- Giữ đường ray riêng tư. Hướng dẫn vLLM hệ thống kép của NVIDIA lưu ý lưu lượng phối hợp Ray, NCCL và vLLM trên các đường ray đó là không xác thực, vì vậy hãy coi cả thiết bị và các cáp giữa chúng là một ranh giới tin cậy duy nhất.
- Công suất dự tính trên mỗi đơn vị. Mỗi đơn vị được trang bị nguồn điện 1.600W, vì vậy hãy lên kế hoạch cho một nguồn điện công suất cao chuyên dụng. Hai cái có thể cần ít nhất 2 ổ cắm 220V.
- Phù hợp với hệ thống phần mềm. NVIDIA mong đợi cùng một phiên bản firmware, hệ điều hành, driver, CUDA và DOCA/OFED trên cả hai hệ thống trước khi cài đặt.
2 hệ thống GB300 mở khóa cho Agentic AI
Hai thiết bị cung cấp cho bạn hai GPU, 504GB HBM3e, tổng cộng 1.496GB bộ nhớ coherent trên hai pool riêng biệt, và lên đến 40 petaFLOPS FP4 thưa. Cách bạn chi tiêu số tiền đó phụ thuộc vào mẫu triển khai nào trong bốn mẫu phù hợp với khối lượng công việc của bạn.
| Pattern | Cái gì, chạy ở đâu | Sức tải trên kết nối 800Gb/s | sự dư thừa |
|---|---|---|---|
| Chia vai trò | Bộ điều phối trên đơn vị A, mô hình dụng cụ và thực thi trên đơn vị B | Nhẹ (prompt và phản hồi) | Một phần |
| Shard một mô hình lớn | Một mẫu được chia cho cả hai GPU | Nặng (kích hoạt mỗi token) | Không có |
| Độ sẵn sàng cao | Ngăn xếp giống hệt nhau được phản chiếu trên cả hai | Tối thiểu | đầy đủ |
| Phiên làm việc song song với ngữ cảnh dài | Phiên làm việc được chuyển đến bất kỳ đơn vị nào | Tối thiểu | đầy đủ |
Phân chia khối lượng công việc Agentic AI trên hai hệ thống
Unit A dành 252GB HBM3e cho mô hình orchestrator và bộ nhớ đệm KV — trạng thái chú ý lưu trữ tăng theo ngữ cảnh. Đơn vị B vận hành tầng thực thi, với các mô hình dụng cụ được cô lập trong các phân vùng MIG riêng biệt khi thích hợp. Kế hoạch và kết quả di chuyển giữa các hệ thống dưới dạng lưu lượng văn bản nhẹ.
- Phù hợp cho: Các quy trình Agentic AI sử dụng mô hình suy luận lớn cùng với mã hóa, truy xuất, rào chắn bảo vệ, thị giác hoặc mô hình giọng nói.
- Ưu điểm chính: Mỗi mô hình vẫn giữ nguyên tốc độ cao ở HBM cục bộ, trong khi kết nối 800Gb/s chỉ mang theo các nhắc nhở và phản hồi thay vì kích hoạt từng token.
- Đánh đổi: Khối lượng công việc phải được phân công và định tuyến qua hai hệ thống riêng biệt.
Phân mảnh một mô hình AI lớn trên hai GPU
Hai hệ thống này cung cấp tổng cộng 504GB HBM3e. Ví dụ, một mô hình 550 tỷ tham số với độ chính xác 4-bit cần khoảng 275GB chỉ riêng trọng số. Quy trình làm việc vLLM hệ thống kép của NVIDIA hướng tới loại triển khai này với mô hình hỗn hợp chuyên gia Nemotron 3 Ultra tham số 550B.
- Tốt nhất cho: Một mô hình suy luận hoặc điều phối có trọng lượng và bộ nhớ đệm KV vượt quá 252GB HBM3e của một hệ thống.
- Ưu điểm chính: Sharding cung cấp đủ dung lượng bộ nhớ nhanh để chạy các mô hình không thể vừa hoàn toàn trong một HBM của GPU.
- Trao đổi: Kích hoạt sẽ vượt qua liên kết RoCE trên mọi token. Song song đường ống, vốn gán cho mỗi GPU một nhóm lớp liên tục, thường phù hợp hơn cho kết nối này so với song song tensor. Sử dụng cả hai hệ thống cho một mô hình cũng loại bỏ sự trùng lặp ở cấp nút.
Cấu hình tính sẵn sàng cao và dự phòng
Phản chiếu toàn bộ ngăn xếp agent trên cả hai hệ thống và đặt một bộ cân bằng tải ở phía trước. Cấu hình chủ động phân phối lưu lượng bình thường trên cả hai nút, trong khi chế độ chờ chủ động giữ cho một hệ thống sẵn sàng như một dự phòng ấm.
- Tốt nhất cho: Dịch vụ nhân viên luôn hoạt động như cơ phó nội bộ, nhân viên phân loại vé và hệ thống giám sát.
- Ưu điểm chính: Dịch vụ Agent có thể duy trì trong quá trình bảo trì, cập nhật driver hoặc sự cố phần cứng trên một nút.
- Đánh đổi: Mỗi mô hình phải vừa trên một hệ thống duy nhất, và dung lượng trùng lặp không thể kết hợp để lưu trữ mô hình lớn hơn.
Chạy các phiên AI Song song ngữ cảnh dài
Các phiên làm việc được định tuyến đến bất kỳ hệ thống nào thay vì chia sẻ một GPU. Điều này phân phối nhu cầu KV-cache ngày càng tăng do tài liệu truy xuất, kết quả công cụ và ngữ cảnh tích lũy.
- Phù hợp cho: Các nhóm vận hành nhiều agent độc lập với ngữ cảnh lớn, sản lượng công cụ rộng hoặc lịch sử thực thi lâu dài.
- Ưu điểm chính: Hai hệ thống tăng gấp đôi HBM khả dụng cho các bộ nhớ đệm KV độc lập, giảm hàng đợi và hỗ trợ các phiên chạy dài đồng thời hơn.
- Đánh đổi: Bộ nhớ vẫn được chia giữa hai nhóm riêng biệt, nên một phiên không thể tự động sử dụng dung lượng kết hợp mà không có phân mảnh mô hình.
| Thông số kỹ thuật | 1x WorkStation với B300 | 2x WorkStation với B300 | Máy chủ HGX B300 |
|---|---|---|---|
| GPU | 1 Blackwell Ultra | 2 Blackwell Ultra | 8 Blackwell Ultra (B300 SXM) |
| Bộ nhớ GPU (HBM3e) | 252GB | 504GB | 2.304GB |
| Bộ nhớ tổng kết hợp | 748GB | 1.496GB (hai pool) | HBM cộng với bộ nhớ máy chủ, phụ thuộc vào cấu hình |
| Băng thông tổng hợp HBM | 7.1TB/s | 14.2TB/s | Lên đến 64TB/s |
| Tính toán AI FP4 | Tối đa 20 PFLOPS (thưa) | Tối đa 40 PFLOPS (thưa) | Lên đến 144 PFLOPS |
| Liên kết GPU với GPU | N/A | 2x 400Gb/s RoCEv2 (~100GB/s) | NVLink 5 ở tốc độ 1.8TB/s mỗi GPU |
| Mở rộng quy mô | Ghép đôi với một đồng đẳng | Giá trị tối đa được ghi nhận | 8x ConnectX-8 với tốc độ 800Gb/s mỗi GPU, vải chuyển mạch |
| Triển khai | Bộ nguồn để bàn, 1.600W | Hai thiết bị bàn làm việc, hai mạch điện | Máy chủ giá đỡ (8U khí nén hoặc 4U làm mát bằng chất lỏng) |
| Khi nào nên chọn | • Mẫu lớn nhất của bạn cùng bộ nhớ đệm KV vừa với 252GB HBM3e • Một nhóm đang phát triển và kiểm thử các agent với số lượng người dùng đồng thời thấp • Thời gian ngừng hoạt động thỉnh thoảng là chấp nhận được |
• Cần bộ nhớ nhanh hơn 252GB hoặc tổng cộng hơn 748GB • Cần dự phòng • Không gian rack và nguồn điện/làm mát trung tâm dữ liệu không phải là lựa chọn • Muốn có một suy luận riêng biệt nhưng chuyên biệt, tinh chỉnh. |
• Cần phục vụ song song tensor các mô hình có hàng nghìn tỷ tham số ở sản lượng sản xuất • Hàng chục hoặc hàng trăm người dùng đồng thời • Khối lượng công việc là tinh chỉnh và/hoặc huấn luyện đa nút • Bạn mong đợi phát triển vượt qua hai nút thành một cụm chuyển đổi |
Cấp độ mà với 2 máy trạm GB300 vẫn chưa thể so sánh với hệ thống NVIDIA HGX và cụm rack
Hai thiết bị liên kết mở rộng khả năng của bàn làm việc, nhưng chúng vẫn là hai máy tính riêng biệt được kết nối bằng Ethernet. Giới hạn xuất hiện ở bốn điểm:
- Băng thông kết nối: ~100GB/s giữa các thiết bị so với 1.8TB/s NVLink mỗi GPU bên trong HGX B300, khoảng cách 18 lần loại trừ khả năng song song tensor hiệu quả trên cặp.
- Mức trần nâng quy mô (scaling): Hai unit là mức cao nhất. Một node HGX cắm vào các fabric Ethernet InfiniBand hoặc Spectrum-X có khả năng mở rộng lên nhiều node.
- Huấn luyện: Việc tinh chỉnh mô hình phù hợp cho một unit thì sẽ hoạt động hiệu quả. Huấn luyện bất cứ thứ gì vượt qua 2 unit đều bị ràng buộc bởi vấn đề kết nối.
- Vận hành: Hai hệ thống tại bàn làm việc được quản lý riêng biệt. Máy chủ HGX được lắp trực tiếp vào các bộ lập lịch cụm (cluster scheduler) hiện có, giám sát và lưu trữ chia sẻ
Câu hỏi thường gặp
Tôi có cần một bộ chuyển mạch mạng để kết nối hai thiết bị không?
Không. Hai cáp QSFP kết nối trực tiếp các thiết bị, mỗi ray 400Gb/s một cáp.
Tôi có thể kết nối nhiều hơn hai thiết bị không?
NVIDIA ghi lại việc phân cụm hai hệ thống và không công bố cấu hình nào vượt quá mức đó. Các nhóm cần thêm node nên xem xét hạ tầng HGX quy mô rack.
Hai thiết bị này có hoạt động như một GPU lớn không?
Không. Chúng hoạt động như hai nút trên RoCEv2, và các framework như vLLM với Ray, hoặc đào tạo dựa trên NCCL, xử lý việc phân phối công việc giữa chúng.
Liệu một đơn vị có thể thực sự chạy mô hình 1 nghìn tỷ tham số không?
NVIDIA đánh giá cho các mẫu lên đến 1 nghìn tỷ tham số trong kho dữ liệu 748GB. Bất cứ thứ gì vượt quá 252GB HBM3e đều chạy từ LPDDR5X chậm hơn, nên hãy mong đợi số token trên giây thấp hơn so với một mẫu chỉ chứa đầy bộ nhớ GPU.
Tôi nên bắt đầu với hình mẫu nào?
Chia vai trò. Nó giữ mọi mô hình trong bộ nhớ cục bộ nhanh, gần như không gây tải lên liên kết, và vẫn để lại tùy chọn cấu hình lại cho sharding hoặc độ sẵn sàng cao sau này.
Kết luận
Hai unit liên kết hợp lý nhất khi hệ thống agent đã vượt quá bộ nhớ nhanh của một GPU nhưng không đủ ngân sách cho hệ thống rack. Hãy cân nhắc mô hình orchestrator và bộ nhớ đệm KV của bạn so với 252GB HBM3e trước. Nếu nó vừa khớp, thiết bị thứ hai nên dùng cho các mô hình tools hoặc dự phòng. Nếu không, việc phân mảnh trên cặp này sẽ tạo ra headroom nhưng đổi lại tốc độ trên mỗi token, và khối lượng công việc cần nhiều hơn thế sẽ là tín hiệu để lên kế hoạch triển khai HGX B300.
Scaling Agentic AI tại bàn với máy trạm GB300
Các hệ thống workstation dựa trên GB300 đang đượng cung cấp tại Nhất Tiến Chung dành cho các nhóm chạy AI agent cục bộ và có thể cấu hình 2-node phù hợp với hệ thống cáp cần thiết cho thiết lập hai node. Đối với các khối lượng công việc đã vượt quá giới hạn phần cứng desktop, Nhất Tiến Chung cũng cung cấp các máy chủ HGX B300 và triển khai ở cấp độ rack.